 엔지니어링
노드 장애에도 동작하는 외부 모니터링 경로 구성
· 핀로그
- #monitoring
- #failure-domain
- #kubernetes
- #observability
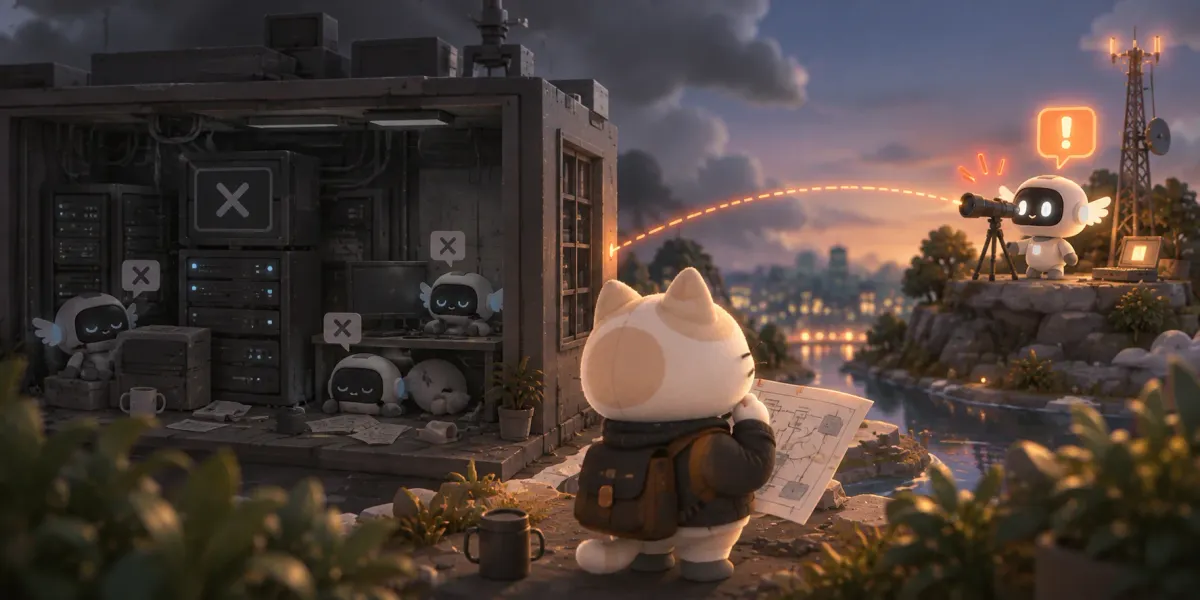
서버 안에 모니터링을 설치하고 알림까지 연결하면, 장애를 지켜볼 준비가 끝난 것처럼 보입니다. 하지만 질문을 하나 바꾸면 빈틈이 드러납니다. 애플리케이션이 아니라 서버 자체가 멈추면, 누가 알림을 보내줄까요?
핀로그는 AWS의 단일 노드에서 k3s 컨트롤 플레인과 애플리케이션을 함께 운영하는 구조였습니다. k3s는 가볍게 만든 Kubernetes 배포판이고, 컨트롤 플레인은 클러스터를 관리하는 구성요소입니다.
지표를 모으는 Prometheus와 알림을 처리하는 Alertmanager도 그 노드 위에 있었습니다. 서비스 상태를 수집하는 쪽과 그 상태를 전달하는 쪽이, 감시 대상과 같은 서버의 생존에 기대고 있었죠.
문제
Prometheus·Alertmanager와 호스트의 알림 수신기 Sentinel이 모두 감시 대상과 같은 단일 AWS 노드에 있었다. 노드 전체가 멈추면 알림 경로도 함께 멈출 수 있었다.
결정
내부 알림 경로는 그대로 두고, GitHub-hosted 환경에서 HTTPS/TLS 접근을 점검해 결과를 Mattermost로 직접 보내는 외부 경로를 따로 뒀다.
결과
노드 밖에서 접근 가능성을 확인하는 경로가 생겼다. 다만 서비스가 복구되거나 고가용성 구조가 되는 것은 아니고, 두 경로가 모두 Mattermost에 도착한다는 의존성은 남는다.
함께 멈추는 분리된 프로세스
이 문제를 설명하는 말이 장애 도메인(failure domain)입니다. 하나의 장애로 함께 영향을 받는 범위를 뜻합니다. 애플리케이션과 모니터링이 서로 다른 Pod에 있고 별도 namespace로 관리되더라도, 같은 노드가 멈추면 둘 다 실행할 수 없습니다. 논리적인 분리와 장애에 대한 독립성은 다른 이야기입니다.
내부 모니터링이 쓸모없다는 뜻은 아닙니다. 노드가 동작하는 동안에는 리소스와 워크로드 상태를 보고 문제의 단서를 모을 수 있습니다. 다만 노드 전체 장애를 알리는 마지막 수단까지 내부 경로에 맡기면, 알림을 보내야 할 순간에 알림 시스템도 함께 사라질 수 있어요.
외부 관측 위치 추가
핀로그의 내부 알림은 Prometheus가 수집한 지표와 규칙 평가에서 시작해 Alertmanager를 거칩니다. 그다음 호스트(클러스터 바깥, 노드의 운영체제)에서 도는 수신기 Sentinel Receiver가 받아 팀 메신저 Mattermost로 전달하는 구조입니다. 아래는 알림이 이동하는 순서입니다.
Prometheus
클러스터 내부 지표 수집·규칙 평가Alertmanager
발생한 알림 처리Host Sentinel
호스트에서 알림 수신·가공Mattermost
운영자가 알림 확인
여기서 중요한 건 Sentinel이 클러스터 안이 아니라 호스트에 있다는 사실만으로 노드 장애에서 독립하지는 않는다는 점입니다. 실행 층은 달라도 같은 노드에 기대고 있습니다. 호스트 프로세스로 옮기는 것은 경계를 하나 넘는 일이지만, 이번에 피해야 할 경계인 노드 전체의 장애 도메인을 넘는 일은 아닙니다.
그래서 외부 HTTPS/TLS 모니터는 GitHub-hosted 환경(GitHub이 운영하는 실행 환경)에서 동작하고, 결과를 Mattermost로 직접 전달하도록 경로를 나눴습니다. 서비스 노드의 Prometheus나 Sentinel을 경유하지 않습니다. 내부 알림을 없애거나 전체 관측 스택을 옮기는 대신, 노드 밖에서 접근 가능성을 확인하는 별도 경로를 둔 것입니다.
GitHub-hosted 실행
서비스 노드 밖에서 점검 시작HTTPS / TLS
외부에서 서비스 접근 상태 확인Mattermost
내부 수신기를 거치지 않고 직접 전달
핵심은 실행 서비스의 이름보다 위치와 의존성입니다. 외부에서 점검하더라도 결과를 장애가 난 노드의 수신기로 다시 보내야 한다면, 끝에서 같은 문제를 만납니다. 점검을 시작하는 곳뿐 아니라 운영자에게 전달되기까지의 경로도 함께 봐야 합니다.
중복 관측이 아닌 두 경로
내부와 외부 경로는 답하는 질문이 다릅니다. 내부 관측은 서비스 안에서 무슨 일이 벌어지는지 설명할 단서를 줍니다. 외부 점검은 서비스 밖에서 접속할 수 있는지를 봅니다. 하나는 원인에 가까운 정보를, 다른 하나는 외부에서 드러나는 증상을 다루는 셈입니다.
내부 관측
Prometheus · Alertmanager · 호스트 Sentinel
지표와 알림으로 내부 상태를 살핍니다. 수집·전달 과정이 서비스 노드의 실행 환경에 의존합니다.
외부 점검
GitHub-hosted HTTPS/TLS 모니터
노드 밖에서 접근 상태를 확인합니다. 내부 알림 경로를 우회하지만, 내부 원인까지 설명하지는 못합니다.
같은 노드에 모니터링 프로세스를 더 두는 방법은 이 문제의 대안이 되기 어렵습니다. 프로세스 수가 늘어도 노드 전체 장애에는 함께 영향을 받기 때문입니다. 반대로 외부 점검만 남기면 내부 상태를 설명할 정보가 줄어듭니다. 두 경로를 병행하는 이유는 중복된 도구를 갖추기 위해서가 아니라, 서로 다른 관측 범위를 남기기 위해서입니다.
접속 실패와 노드 사망의 구분
외부 모니터가 실패를 보고했다고 해서 노드가 죽었다고 바로 결론 내릴 수는 없습니다. 노드 전체 장애는 접속 실패를 일으킬 수 있지만, DNS 문제나 네트워크 경로, TLS 설정, 애플리케이션 응답 문제도 외부 점검의 실패로 나타날 수 있습니다. 점검 결과는 관측한 현상이고, 장애 원인은 그다음에 확인할 대상입니다.
따라서 외부 실패 신호를 읽을 때 첫 질문은 “서버가 죽었나?”보다 “어느 관측 지점에서 무엇이 실패했나?”에 가까워야 합니다. 이어서 내부 지표를 볼 수 있는지, 호스트에 접근할 수 있는지 확인하며 범위를 좁힐 수 있습니다. 외부 신호는 조사의 출발점이지 진단의 종착점이 아닙니다.
또한 노드 밖에 있다는 것이 모든 장애에서 독립한다는 뜻은 아닙니다. 외부 실행 환경과 네트워크, 알림 목적지 역시 의존성입니다. 특히 두 경로의 최종 도착지는 모두 Mattermost입니다. 점검이 실행되는 것과 사람이 알림을 받는 것은 구분해서 봐야 합니다.
도구보다 먼저 그릴 경계
이 구성에서 제가 중요하게 보는 변화는 모니터링 도구의 개수가 아닙니다. 내부 상태를 설명하는 경로와, 그 내부가 멈췄을 때에도 밖에서 확인을 시도할 경로를 구분했다는 점입니다. 외부 감시를 둔다고 서비스가 복구되거나 단일 노드가 고가용성 구조로 바뀌지는 않습니다. 알 수 있는 범위를 넓히는 일과 서비스를 계속 살려 두는 일은 별개의 과제입니다.
모니터링 구성을 검토할 때는 이제 구성요소 이름만 늘어놓기보다, 같은 장애에 묶이는 것들을 먼저 묶어 보려 합니다. 수집기, 규칙 평가기, 수신기, 알림 목적지까지 선을 따라가며 “이 노드가 없어져도 이 단계는 동작할 수 있는가?”를 묻는 것입니다.
서버가 죽으면 그 서버 안의 감시자도 죽습니다. 그래서 감시 대상을 더 자세히 보는 일만큼, 감시자가 어디에 서 있는지 확인하는 일이 중요합니다.