 AI 에이전트
장애 알림의 AI 가공과 코드 기반 출력 검증
· 핀로그
- #observability
- #alerting
- #hermes
- #ai-agent
장애 알림에 AI를 붙일 때, 문장을 잘 쓰는 것보다 먼저 정해야 할 문제가 있었습니다. AI가 어디까지 결정해도 되는가? 알림을 읽기 좋게 가공하는 일과 채널 전체를 호출하는 일은 같지 않습니다. 설명 한 문장이 달라지는 것과 멘션 정책이 달라지는 것도 무게가 다르고요.
핀로그에서는 알림을 받아 전달하는 Sentinel이 AI 에이전트 도구 Hermes를 통해 알림 payload(알림에 담겨 오는 원본 데이터)를 가공하도록 했습니다. 다만 AI가 만든 결과를 그대로 최종 메시지로 취급하지는 않았습니다. 멘션(mention), URL, 형식은 신뢰할 수 있는 코드(trusted code)가 다시 검증합니다.
문제
장애 알림에 AI를 붙이면, 설명을 가공하는 일과 함께 누구를 호출하고 어떤 링크와 형식을 내보낼지까지 생성 결과에 맡기게 될 수 있었다. 그러면 운영 정책이 생성 결과에 종속된다.
결정
Hermes는 알림 payload를 가공하고, mention·URL·형식은 trusted code가 다시 검증하게 했다. 심각도·상태별 호출과 반복 정책, 마지막 한 줄 요약의 자리는 정책으로 고정했다.
결과
“AI를 신뢰할 것인가”라는 큰 질문을 “어떤 결과를 코드가 확인해야 하는가”라는 구체적인 질문으로 바꿀 수 있었다. 다만 형식이 맞아도 내용이 사실인지까지 보장되지는 않는다.
설명이자 호출 신호인 알림
운영 알림을 받는 사람은 무엇이 발생했는지, 아직 진행 중인지, 지금 무엇을 해야 하는지를 알아야 합니다. payload를 사람이 읽을 수 있는 내용으로 가공하는 이유도 여기에 있어요. 하지만 메시지에는 설명만 들어 있지 않습니다. 멘션은 다른 사람의 주의를 요청하고, URL은 다음에 확인할 곳을 가리킵니다.
그래서 이 셋을 모두 자유로운 문장 생성 문제로 두고 싶지는 않았습니다. 표현을 바꿀 수 있다는 이유로 호출 대상이나 메시지 규칙까지 바뀌면, 운영 정책이 생성 결과에 종속됩니다. 알림마다 그럴듯한 문장을 얻는 것보다 같은 상태에는 같은 정책을 적용하는 것이 먼저였습니다.
Hermes 가공, 코드 판정
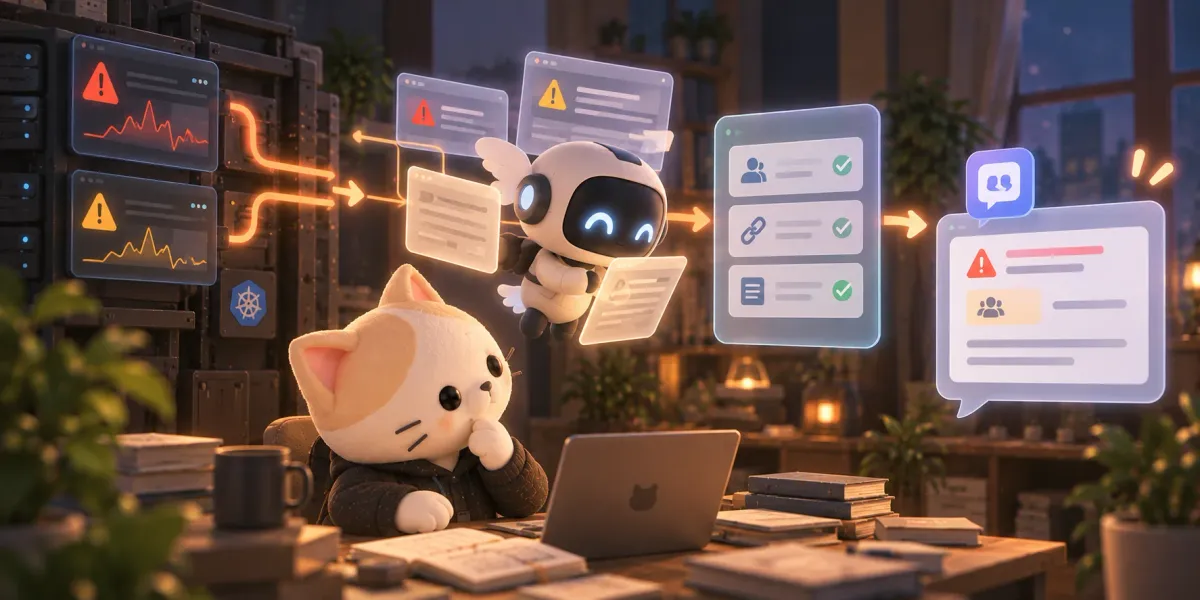
클러스터 내부에서 발생한 알림은 이렇게 흐릅니다. 모니터링 도구 Prometheus가 알림을 만들고, Alertmanager가 이를 호스트의 Sentinel Receiver로 넘깁니다. Sentinel은 이 알림을 팀 메신저 Mattermost로 전달합니다. Sentinel은 알림 전용 Hermes 프로필을 씁니다. 여기서 중요한 것은 프로필 이름보다, 가공 단계 뒤에 별도의 코드 검증이 있다는 점입니다.
Prometheus
알림 발생Alertmanager
알림 전달Sentinel Receiver
Hermes 가공 · 코드 재검증Mattermost
운영 메시지 전달
이 흐름에서 Sentinel의 역할을 나누면 다음과 같습니다. AI를 쓰는 구간을 숨기지 않고, AI의 결과가 어디에서 운영 규칙과 만나는지를 분명하게 두었습니다.
Hermes가 맡는 일
알림 payload를 가공합니다. 사람이 읽을 메시지를 만드는 단계에 참여합니다.
Trusted code가 맡는 일
가공 결과의 mention, URL, 형식을 다시 검증합니다. 생성된 문장이 최종 형식의 권위가 되지는 않습니다.
모든 내용을 고정 문구로만 보내는 방식과 비교하면, 이 구조에는 가공 결과를 다시 확인하는 단계가 생깁니다. 생성 결과를 그대로 보내는 방식과 비교하면 AI의 재량은 줄어듭니다. 저는 그 제한을 받아들이기로 했습니다. 설명을 가공할 여지는 남기되, 운영 메시지의 규칙까지 넘기지는 않는 선택이었습니다.
이때 trusted code는 AI의 설명을 무조건 옳게 만들어 주는 장치가 아닙니다. 무엇을 호출하고 어떤 링크와 형식을 내보낼지에 대한 경계입니다. 문장이 자연스럽다는 이유만으로 그 경계를 통과한 것으로 보지 않는 게 핵심이었어요.
정책으로 고정한 심각도·상태
알림 정책은 Critical과 Warning을 구분하고, FIRING과 RESOLVED도 구분합니다. FIRING은 알림이 활성화된 상태이고, RESOLVED는 해소된 상태입니다. 반복 주기와 멘션은 한 묶음으로 뭉뚱그리지 않고 각각 읽을 수 있어야 합니다.
Critical FIRING
@channel1회, 반복 알림 주기는 1시간입니다.Warning FIRING
멘션 없이 전달하며, 반복 알림 주기는 6시간입니다.
RESOLVED
해소 알림은 항상 전송하는 정책입니다.
Critical은 @channel로 한 번 부르고 1시간마다 다시 알리게, Warning은 멘션 없이 6시간마다 다시 알리게 했습니다. 반복 알림의 멘션 처리나 같은 사건을 묶는 방식은 이 글에서 다루지 않습니다. 핵심은 심각도에 따라 부르는 방식과 반복 주기를 나눴다는 점입니다.
RESOLVED를 남기는 이유는 시작 알림만으로는 사건의 현재 상태를 알 수 없기 때문입니다. 경고를 본 사람이 해소 여부를 추측하게 두지 않으려는 정책이죠. 여기서 “항상 전송”은 해소 상태를 전송 대상으로 삼는다는 뜻입니다. 네트워크나 수신 시스템의 상태와 무관하게 반드시 도착한다는 전달 보장은 아닙니다.
마지막 한 줄의 세 가지 정보
운영 알림의 마지막 줄은 발생 내용, 현재 상태, 필요 행동을 담은 한 줄 요약으로 정했습니다. 짧게 끝내려는 장식이 아닙니다. 읽는 사람이 마지막에 확인할 정보의 자리를 고정한 것입니다.
발생 내용 · 현재 상태
무엇이 일어났는지와 지금 어떤 상태인지를 함께 읽습니다. 발생 사실만 보고 지금도 진행 중이라고 추측하지 않게 합니다.
필요 행동
설명을 읽은 뒤 무엇을 해야 하는지 확인합니다. 상황 설명만 있고 다음 행동이 빠진 요약과 구분합니다.
“무슨 일이 있었는가”만 적으면 현재 상태가 빠집니다. “지금 정상인가”만 적으면 어떤 사건이 있었는지가 사라집니다. 필요 행동까지 함께 두어야 알림을 읽는 목적이 이어집니다. AI가 내용을 가공하더라도 이 마지막 줄의 역할은 달라지지 않습니다.
형식 통제와 사실 보장의 차이
돌아보면 이 설계에서 중요했던 것은 AI를 알림 경로에 넣었다는 사실보다, 넣고도 넘기지 않은 책임이었습니다. payload 가공과 운영 규칙을 분리하니 “AI를 신뢰할 것인가”라는 큰 질문을, 어떤 결과를 코드가 확인해야 하는가라는 구체적인 질문으로 바꿀 수 있었습니다.
다만 형식의 정확성과 내용의 사실성은 별개입니다. 멘션과 URL, 메시지 형식이 규칙에 맞아도 설명이나 필요 행동이 실제 상황에 맞는지는 다른 문제입니다. 이 경계를 원인 진단의 정확성을 보장하는 장치로 생각해서는 안 됩니다.
제가 가져갈 원칙은 단순합니다. AI에는 정보를 가공하는 역할을 주되, 사람의 주의를 호출하고 최종 메시지의 규칙을 적용하는 책임은 코드에 남깁니다. 알림에 AI를 붙이는 작업은 더 많은 결정을 맡기는 일만은 아니었습니다. 맡기지 않을 결정을 먼저 정하는 일이기도 했습니다.