 엔지니어링
로컬 모델 동시 생성 수를 5에서 3으로 줄인 근거
· 야누스
- #local-llm
- #mlx
- #performance
- #kv-cache
야누스는 로컬 모델 서버에 동시에 보낼 수 있는 생성 요청 수를 제한합니다. 이걸 생성 슬롯이라고 부르고, 하위 에이전트(worker), 채팅, 검증 대기 등이 이 슬롯을 나눠 씁니다. 슬롯이 다 차면 새 worker는 만들지 않고, 왜 만들지 않았는지를 기록합니다.
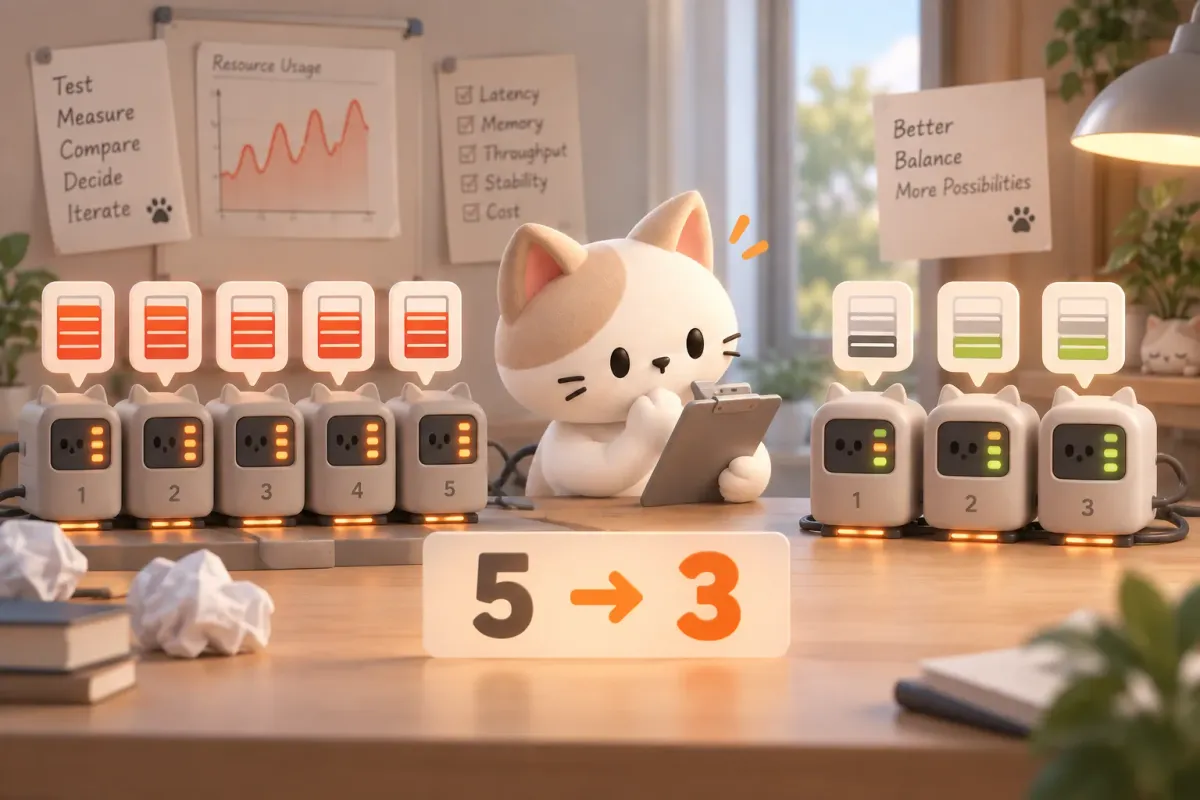
이 기본값은 처음에 5였고, 지금은 3입니다. 바꾼 근거와, 앞으로 늘릴 때의 조건을 정리합니다.
5로 시작한 이유
슬롯 기능을 넣을 때 3과 5 중 어느 쪽을 기본값으로 할지 정하지 못한 채 5로 출하했습니다. 근거가 있어서 고른 숫자는 아니었어요.
3으로 줄인 근거
실행 환경은 48GB 메모리의 Apple Silicon 맥이고, 모델은 Qwen3.8 27B를 4-bit로 줄인(양자화한) 것입니다. 세 가지를 따져 봤습니다.
KV 캐시는 요청마다 따로 쌓인다
KV 캐시는 이전 토큰의 계산 결과를 저장해 두는 메모리입니다. 요청마다 따로 잡히고, worker 하나의 예산이 49K 토큰이면 최악의 경우 요청 하나에 5~12GB가 듭니다. 이런 요청이 5개 동시에 돌면 메모리가 모자라 스왑으로 넘어갑니다.
GPU가 하나라 동시 생성의 이득이 작다
Apple Silicon에서는 GPU(Metal) 하나가 모든 생성을 처리합니다. 동시에 여러 요청을 돌려서 얻는 이득은 한 요청이 도구 실행을 기다리는 동안 다른 요청이 생성하는 정도라, 2~3개에서 더 늘지 않습니다.
동시성이 높을수록 MTP 효과가 줄어든다
MTP(Multi-Token Prediction)는 여러 토큰을 미리 예측해 한 번에 확정하는 방식입니다. 예측이 맞아야 빨라지는데, 동시에 처리하는 요청이 많을수록 맞는 비율이 떨어집니다.
실제 사용 기록도 같은 결론이었습니다. 그 주기 동안 동시 생성은 최대 3개였고, 슬롯을 기다린 시간은 p95(대기 시간을 줄 세웠을 때 상위 5%를 뺀 가장 긴 값) 기준 0.012ms였어요. 5개가 필요한 적이 없었습니다.
5 → 3
기본 생성 슬롯
3
실측 최대 동시 생성
0.012ms
슬롯 대기 p95
늘리는 조건은 측정으로
기본값을 줄이는 대신, 슬롯이 실제로 부족할 때 알 수 있게 했습니다. 원래도 "슬롯 대기가 실제로 병목일 때만 GPU 메모리(VRAM) 기준으로 슬롯을 다시 계산한다"는 판정 함수가 있었는데, 실행 중에 아무도 이 함수를 부르지 않고 있었어요. 판단에 쓸 대기 시간 기록도 없어서, 이 조건은 영원히 참이 될 수 없었습니다.
- 야누스의 스케줄러(요청에 슬롯을 나눠 주는 부분)가 슬롯을 내줄 때마다 실제 대기 시간을 최근 512건까지 기록합니다. 도구 실행이나 검증 대기는 섞지 않습니다. 자주 일어나는 도구 대기가 섞이면 p95가 흐려지기 때문이에요.
- 대기 시간 p95가 1초 이상이고 기록된 대기가 10건 이상일 때만 "증설 권장"을 띄웁니다. 운영 화면에서 2초마다 이 판정을 볼 수 있습니다.
- 권장이 뜬 뒤에만 설정 화면이나 환경 변수
JANUS_MODEL_SLOTS로 슬롯을 늘립니다. 설정 화면에서는 1~8 사이로 조절합니다.
실기기에서 처음 이 기록을 돌렸을 때는 기록된 대기가 2건뿐이라 "표본 부족"으로 판정을 미뤘습니다. 근거가 모이기 전에는 늘리지 않는다는 규칙대로 동작한 셈입니다.
정리
로컬 모델에서는 동시에 많이 돌리는 것보다 메모리 안에서 안정적으로 돌리는 게 먼저였습니다. 기본값은 계산과 실측으로 3으로 정했고, 늘리는 건 대기 시간을 측정해서 필요하다고 나올 때로 미뤘습니다.