 엔지니어링
배포를 위한 실행 계약과 인프라 책임 경계 정리
· 핀로그
- #GitOps
- #Kubernetes
- #DevOps
핀로그에서 제 역할은 각 파트가 만든 서비스를 Kubernetes에 배포하고, 필요한 연결을 구성하고, 상태를 관찰하고 복구하는 일이었어요.
개발을 시작하기 전에 팀은 구조와 규약, 각자의 책임을 문서로 합의했습니다. 이 글은 그 합의가 배포에서 어떤 형태가 되었는지에 대한 이야기입니다.
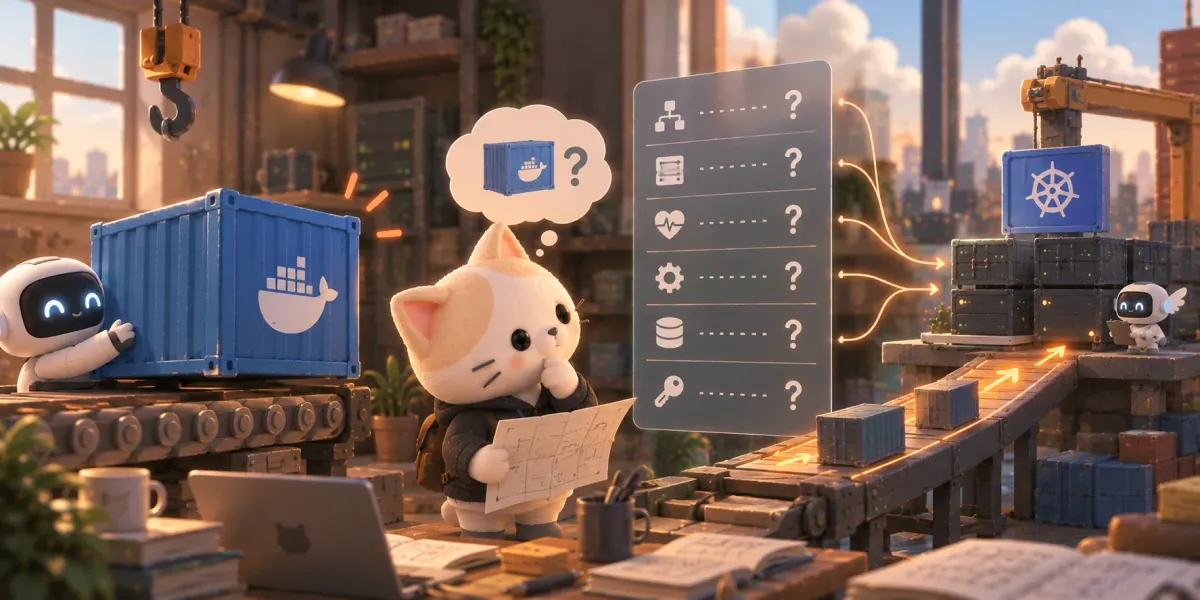
이미지가 있으면 컨테이너를 실행할 수 있습니다. 하지만 어느 포트로 연결해야 하는지, 무엇을 정상 상태로 봐야 하는지, 어떤 설정과 외부 서비스가 필요한지는 이미지 주소만으로 알 수 없어요. 팀에서 배포하려면 이 정보도 함께 전달되어야 했습니다.
문제
이미지 주소만으로는 연결할 포트, 정상 상태의 기준, 필요한 설정과 외부 서비스를 알 수 없었다. 정보가 빠졌을 때 인프라가 다른 담당자의 코드를 고쳐 빈칸을 메울 수도 있었다.
결정
애플리케이션 담당자가 이미지와 실행 계약을 함께 전달하고, 인프라는 배포·연결·관측·복구만 맡기로 했다. 정보가 빠지면 배포를 보류하고 막힌 항목과 담당자를 알린다.
결과
2026년 7월 29일에 역할 경계를 확정했다. 검사 통과와 운영 반영도 구분해, 7월 27일의 pgvector 전환처럼 검사만 통과한 변경은 배포 완료로 부르지 않았다.
배포 가능의 조건
우리는 담당자가 실행 가능한 이미지와 함께 실행에 필요한 계약을 전달하도록 범위를 정했습니다. 인프라는 그 계약에 맞춰 배포하고 연결하는 역할을 맡았어요.
| 전달받을 정보 | 인프라에서 확인할 내용 |
|---|---|
| 이미지의 commit SHA와 digest | 어떤 빌드 결과물을 배포하는가 |
| 컨테이너 포트 | Service가 어디로 연결해야 하는가 |
| health·liveness·readiness 경로 | 어떤 경로로 상태를 확인하는가 |
| 필요한 환경변수·자격증명 키 | 어떤 설정을 안전하게 전달해야 하는가 |
| DB 등 외부 의존성 | 어떤 서비스와 네트워크 연결이 필요한가 |
예를 들어 백엔드 계약에는 내부 포트 8080과 /api/core context path, /api/core/actuator/health 상태 확인 경로가 있었습니다. 이 값은 인프라가 추측해서 정할 것이 아니었습니다. 애플리케이션 담당자가 정의하고, 인프라는 그 정의에 맞춰 연결해야 했죠.
자격증명도 같은 원칙이었습니다. 필요한 키의 구조와 비밀값 자체를 구분하고, 운영 비밀값은 이미지나 Git에 넣지 않은 채 Secret으로 전달하도록 했습니다.
남의 코드는 고치지 않기
제 개인 프로젝트인 알고리즘 스터디 플랫폼 알고수를 혼자 만들 때는 배포 중 문제가 보이면 제가 애플리케이션 코드까지 바꾸면 됐습니다. 팀에서는 그 방식이 그대로 통하지 않았어요.
7월 29일에 확정한 역할 경계는 분명했습니다. 인프라는 배포·연결·관측·복구를 담당하고, 다른 담당자의 애플리케이션 코드를 작성하거나 수정하지 않습니다. 코드리뷰나 API 내부 동작, DB migration 파일과 순서를 대신 결정하는 것도 범위 밖이었습니다.
| 애플리케이션 담당 | 인프라 담당 |
|---|---|
| 실행 가능한 이미지와 실행 계약 전달 | 전달받은 이미지의 Kubernetes 배포 |
| 앱 코드·설정과 probe 내부 동작 | Service·Ingress와 상태 확인 설정 |
| DB migration 파일과 순서 | DB 연결과 배포·복구 절차 |
| 필요한 자격증명 키와 외부 의존성 정의 | Secret 전달 경로와 네트워크 구성 |
정보가 빠졌을 때의 행동도 정했습니다. 인프라가 코드를 대신 고쳐 빈칸을 메우는 대신, 배포를 보류하고 무엇이 막혀 있는지와 담당자를 알리기로 했어요.
저와 함께 인프라 작업을 하는 AI 에이전트 피코(Pico)에게도 같은 경계를 적용했습니다. 에이전트가 코드를 수정할 수 있다는 것과, 그 코드를 수정해도 되는 책임 범위는 별개였습니다.
이미지에서 운영 반영까지
배포는 이미지를 서버에서 직접 실행하는 방식이 아니라 Kubernetes와 Argo CD를 이용한 GitOps 흐름으로 정했습니다. GitOps는 배포 설정을 Git에 두고, 그 변경을 클러스터에 반영하는 방식입니다. Argo CD는 Git의 설정을 클러스터에 맞춰 주는 도구고요.
이미지도 바뀔 수 있는 태그만으로 가리키지 않았습니다. commit SHA와 digest(이미지 내용으로 만든 고유 식별값)를 함께 고정하도록 했어요.
이미지·실행 계약 전달
애플리케이션 담당자가 배포에 필요한 정보를 전달
전달 정보 확인
불완전하면 배포 보류 → 막힌 항목·담당자 확인 → 보완 전달
Infra PR·검증
이미지 참조와 배포 설정을 변경하고 검사·승인
Argo CD 반영·확인
반영 뒤 rollout·상태·로그 확인
제가 정한 배포 흐름입니다. 아래 백엔드 배포는 아직 이 단계를 다 거치지 못했습니다.
Git의 설정이 바뀌었다는 것과 실제 서비스가 정상이라는 것도 구분했습니다. 반영 이후에는 Pod 상태, 이벤트, 로그와 메트릭을 확인하는 일이 남습니다. 인프라의 역할은 이미지 참조를 바꾸는 것으로 끝나지 않았어요.
검사 통과와 배포 완료의 차이
이 차이를 구체적으로 보여주는 기록이 7월 27일의 pgvector 전환 검토입니다.
pgvector는 PostgreSQL에서 벡터 컬럼을 쓸 수 있게 해 주는 확장입니다. 백엔드의 Flyway(DB 스키마 변경을 순서대로 적용하는 도구) migration은 vector 확장을 생성하도록 되어 있었고, AI 쪽 migration은 벡터 컬럼을 사용했습니다. 따라서 운영 PostgreSQL 이미지에도 해당 확장 바이너리가 필요했어요. 애플리케이션이 요구하는 조건과 운영 환경을 맞춰야 하는 지점이었습니다.
당시 인프라 PR은 검사를 통과했지만 열려 있었습니다. 운영 PostgreSQL은 기존 이미지를 유지했고 vector 확장은 아직 없었어요. 백엔드 이미지 게시 workflow 변경도 로컬 커밋에만 있었고, 원격 PR로 전달된 상태는 아니었습니다.
| 7월 27일에 확인한 항목 | 7월 27일 상태 |
|---|---|
| pgvector 전환 Infra PR 검사 | 통과 |
| 해당 PR의 머지 | 미완료 |
| 운영 DB 이미지 전환·재시작 | 미수행 |
vector 확장 생성 | 미수행 |
| 백엔드 이미지 게시 workflow 변경 | 로컬 커밋만 존재 |
그래서 저는 이 변경을 아직 '배포 완료'라고 부르지 않습니다. 배포를 위한 계약을 검토하고 변경안을 검사했지만, 운영 반영은 남아 있습니다.
DB 전환에는 복구 조건도 붙었습니다. 확장을 생성하기 전과 후에는 이전 이미지로 돌아가는 조건이 달랐어요. 확장 생성 후에는 필요한 라이브러리가 없는 기존 이미지로 단순히 되돌리지 않도록 했습니다. 단일 DB replica를 재시작하는 작업이어서 유지보수 승인도 별도로 필요했고요.
백업 역시 파일이 있다는 것만으로 복구 준비가 끝났다고 보지 않았습니다. 당시 DB 백업 파일(archive)은 형식 검사를 통과했지만 사용자 테이블이 없는 초기 DB였습니다. 그래서 이걸 복원 검증으로 치지 않았습니다.
인프라의 책임 범위
이 과정을 돌아보면 인프라 담당자로서 필요했던 것은 모든 코드를 직접 고칠 수 있는 권한이 아니었습니다. 제가 받은 결과물이 어떤 조건에서 실행되는지 알고, 그 조건을 운영 환경에서 충족하는 일이었습니다.
애플리케이션 담당자는 실행 가능한 이미지와 계약을 전달합니다. 인프라는 이를 배포하고 연결한 뒤 관찰하고 복구합니다. 전달이 불완전하면 그 경계에서 멈추고 다시 확인합니다.
개발 전에 팀이 합의한 구조·규약·책임은 배포 과정에서 이런 형태가 되었습니다. 이미지를 받는 것은 시작이었어요. 무엇을 전달받아야 하고, 어디까지 제가 책임져야 하며, 어떤 상태를 아직 완료라고 부를 수 없는지까지 정해야 팀의 배포를 설명할 수 있었습니다.