 AI 에이전트
LLM이 투자 수치를 지어내지 않게 만든 구조
· 핀치
- #llm
- #guardrails
- #prompt-engineering
핀치는 보유 종목과 거래 내역을 바탕으로 수익률, 위험도, 종목 분석을 설명해 주는 AI 투자 비서입니다. 저는 AI 파트를 맡아 AI 서버를 만들었는데, 처음부터 정한 원칙이 하나 있었습니다. LLM이 숫자를 직접 쓰지 않게 하는 것입니다.
LLM에게 수치를 넘기고 문장으로 설명하라고 하면 18.3%를 "약 18%"로, +0.87%p를 "+0.9%p"로 반올림하거나, 없는 숫자를 만들기도 합니다. 투자 정보에서 숫자가 틀리면 설명 전체를 믿을 수 없게 됩니다.
자리표시자 구조
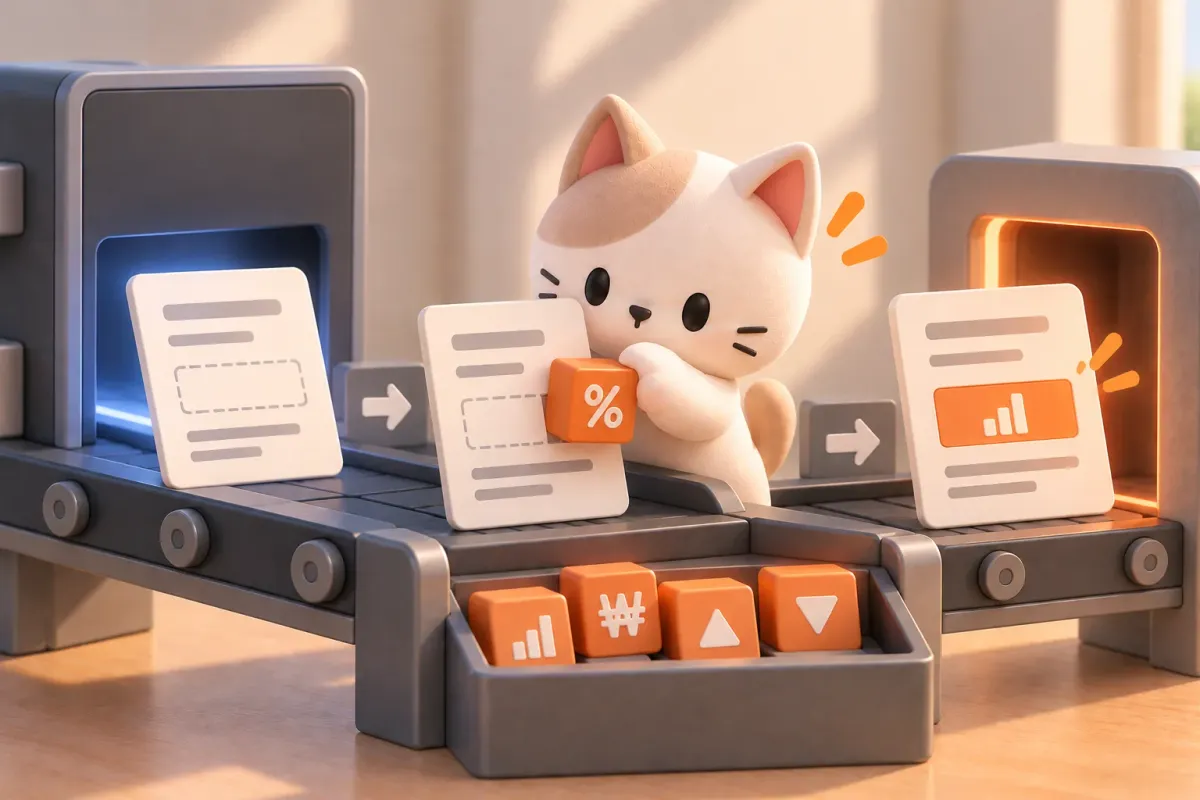
그래서 숫자는 계산 엔진이 만들고, LLM은 숫자가 들어갈 자리만 표시하게 했습니다.
계산 엔진
수익률·비중·위험 지표를 계산키 목록 전달
쓸 수 있는 자리표시자 키만 프롬프트에LLM 작성
숫자 대신 {{key}}로 문장을 씀검사
목록 밖 키, 직접 쓴 숫자를 걸러냄치환
서버가 키를 엔진 값으로 바꿈
예를 들어 LLM은 "SK하이닉스 {{return_000660}}"라고 쓰고, 서버가 이 키를 엔진이 계산한 "+3.4%"로 바꿉니다. 바꿀 때 응답을 글자 조각과 수치 조각(segments)으로 함께 나눠서, 화면에서는 수치만 따로 강조할 수 있습니다.
for match in _PLACEHOLDER_RE.finditer(narrative):
    segment = values.get(match.group(1))
    if segment is None:
        continue
    if match.start() > cursor:
        out.append(Segment.text(narrative[cursor : match.start()]))
    out.append(segment)
cursor = match.end()치환한 값이 엔진 값과 다르면 다시 생성하지 않고 바로 차단합니다. 이 경우는 모델이 아니라 파이프라인이 고장 난 것이라, 다시 생성해서 우연히 맞기를 기대하면 안 되기 때문입니다.
운영을 시작하고 나서 이 구조에서 구멍이 세 군데 나왔습니다.
구멍 1. 모델이 목록을 따로 적어야 했던 구조
처음 응답 형식은 본문과 함께 "본문에서 쓴 자리표시자 목록"과 "인용한 근거 목록"을 따로 적게 되어 있었습니다. 어느 날 종목 분석 섹션이 전부 비어서 나가고 있었는데, 그날 반려 사유를 세어 보니 근거 검사 위반이 102건이었습니다. 모델이 목록에 cit_1 대신 본문 표기 그대로 ^cit_1, {{key}}를 적었고, 검사는 껍데기 없는 id만 맞는 값으로 봤습니다.
표기를 둘 다 알아보게 고친 뒤, 한 단계 더 나가서 목록 자체를 없앴습니다. 본문에 이미 {{key}}와 각주가 들어 있으니 서버가 본문에서 뽑으면 됩니다. 모델에게 본문과 목록을 함께 맞추라고 하는 건 같은 내용을 두 번 적게 하는 일이고, 둘이 어긋나면 섹션이 버려집니다. 응답 형식을 본문 하나로 줄였습니다. 비용 때문에 더 작은 모델로 바꿀 예정이었기 때문에, 모델이 지켜야 할 규칙을 줄이는 쪽이 중요했습니다.
구멍 2. 자리표시자 뒤에 단위를 또 쓰는 문제
치환값에는 부호와 단위가 이미 들어 있습니다(-0.40%p, 41.00%, 1,250원). 그런데 모델이 그 뒤에 단위를 한 번 더 썼습니다. 홈 화면 첫 카드에 "비중은 41.00%%였습니다"가 나갔고, 성과 요인 설명에는 "-0.40%pp 하락"이 나왔습니다.
수치 조각을 보니 원인이 바로 보였습니다. 수치 조각은 "41.00%"였고, 바로 뒤 글자 조각이 "%였습니다"로 시작했어요. 화면 버그가 아니라 모델이 {{key}}%로 쓴 것이었습니다. 프롬프트에 이미 주의 문구가 있었는데도 생긴 일이라, 문구를 더하는 것과 함께 검사를 하나 추가했습니다. 치환하고 나면 자리표시자 경계가 사라지므로, 치환 전 문장에서 {{key}} 바로 뒤에 같은 단위가 오는지 봅니다. 단위가 없는 값({{trading_days}}일 같은 경우)은 건너뛰어서 정상 문장은 걸리지 않게 했습니다.
구멍 3. 값이 하나도 전달되지 않던 경로
마지막 구멍은 데모 직전에 찾았습니다. 채팅에서 보유 종목 수익률을 물으면 "보유 종목별 수익률 데이터가 제공되지 않아 확인하지 못했습니다"라고 답했습니다. 도구는 보유 종목 7개를 정상적으로 조회하고 있었어요.
이 구조에서는 도구가 조회한 수치도 반드시 자리표시자 값으로 등록돼야 생성 단계로 넘어갑니다. 숫자가 이 규칙을 우회하지 못하게 일부러 그렇게 만들었습니다. 그런데 계좌 데이터를 백엔드에서 읽어 오는 경로에서는 값을 등록하는 코드가 한 번도 불리지 않았습니다. 운영에서 확인해 보니 보유 종목은 7개인데 등록된 값은 0개였고, 모델이 받은 안내는 "사용 가능한 수치 자리표시자 없습니다. 수치를 언급하지 마십시오."였습니다. 모델은 규칙을 정확히 지킨 셈이었어요.
값을 등록하도록 고치자 등록된 값이 31개가 됐습니다. 고치면서 하나를 더 찾았는데, 키 이름이 return_000660처럼 종목 코드로 끝나서, 모델이 종목 이름 대신 "000660: +3.4%"처럼 코드를 쓰는 일이 있었습니다. 코드와 이름을 짝지은 표를 함께 넘기도록 했습니다.
고치기 전
"보유 종목별 수익률 데이터가 제공되지 않아 확인하지 못했습니다."
고친 뒤
"SK하이닉스 +3.4%, 대한항공 +19.2%, 현대차 -14.3%, …"
이 수정에는 테스트 4건을 붙였고, 수정을 되돌리면 4건 모두 실패하는 것을 확인했습니다.
정리
자리표시자 구조 덕분에 LLM이 숫자를 지어내는 일은 막을 수 있었습니다. 대신 모든 숫자가 엔진에서 자리표시자로 가는 경로를 거쳐야 해서, 그 경로가 한 군데라도 끊기면 틀린 답 대신 "모른다"는 답이 나옵니다. 세 구멍 모두 모델이 규칙을 어긴 게 아니라, 형식·검사·데이터 경로 중 하나가 규칙과 맞지 않았던 경우였습니다.