 엔지니어링
벡터 검색이 놓친 공시를 단어 검색으로 찾기
· 핀치
- #rag
- #search
- #postgres
- #evaluation
핀치의 AI 설명에는 근거가 붙습니다. "자기주식을 소각했다"고 쓰면 그 공시가 각주로 달리는 식입니다. 근거는 미리 모아 둔 공시·뉴스를 검색해서 가져오는데, 검색이 엉뚱한 문서를 가져오면 설명도 엉뚱해집니다.
이 글은 검색을 벡터 검색 하나로 시작했다가, 문서가 늘자 성능이 떨어져 하이브리드 검색으로 바꾼 과정입니다. 바꿀 때마다 같은 평가셋으로 재서 판단했습니다.
평가셋부터
검색을 고치기 전에 평가셋을 먼저 만들었습니다. 우리가 모은 문서에 실제로 답이 있는 질문만 담고, 정답은 문서 제목의 일부로 지정했습니다("주식소각결정", "유상증자결정" 등). 지표는 Recall@5, 상위 5개 안에 정답 문서가 들어오는 비율이고, 기준선은 0.75로 뒀습니다.
답이 없는 질문도 하나 넣었습니다. "우주 발사체 사업에 진출한다는 공시가 있나요?"처럼 어느 종목에도 해당하지 않는 질문이요. 점수 기준 없이 상위 5개를 고르는 검색은 답이 없어도 항상 무언가를 돌려준다는 사실을 기록해 두기 위해서입니다.
처음: 벡터 검색만으로 0.875
처음에는 임베딩(문장을 의미가 가까울수록 가까운 숫자 벡터로 바꾼 것) 유사도만으로 검색했습니다. 청크(문서를 잘라 둔 조각) 2,280개에서 Recall@5가 0.875(8개 중 7개)였습니다.
놓친 하나는 자기주식 소각 질문이었습니다. 소각 공시에는 "주식 소각 결정"이라는 말이 여러 번 들어 있는데도, 질문과의 유사도가 0.4366에 그쳐 회사별 반기보고서 8건(0.46~0.51)에 밀렸습니다. 처음에는 한 문서가 상위를 독차지하는 문제로 보고 문서당 조각 수 상한을 구현했는데, 1개·2개·무제한 모두 0.875로 같았습니다. 효과가 없어서 되돌리고, 측정 결과만 평가셋에 남겼습니다.
원인은 벡터 검색이 단어가 그대로 겹치는 경우에 약하다는 점이었습니다. 이때 하이브리드 검색이 필요하다고 적어 두었습니다.
문서가 4.5배로 늘자 0.375
엿새 뒤 수집 범위를 넓혀 공시 216건, 청크 10,195개가 됐습니다. KB금융 반기보고서 하나가 6,110개로 절반 이상이었습니다. 같은 방식으로 다시 재 보니 Recall@5가 0.375(8개 중 3개)로 떨어졌습니다. 이 큰 보고서의 조각들이 상위를 차지했기 때문입니다.
단어 검색을 더해 RRF로 합치기
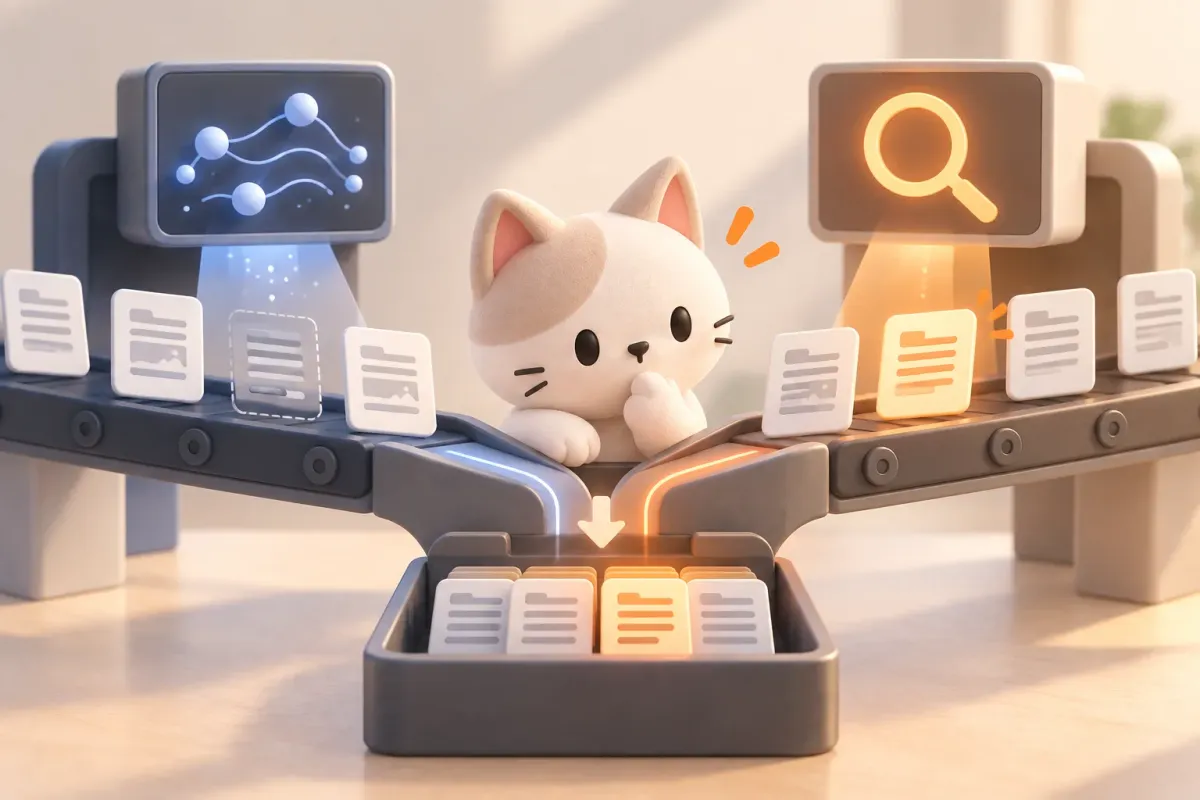
그래서 벡터 검색 옆에 단어 검색 경로를 하나 더 두고, 두 결과를 RRF(Reciprocal Rank Fusion)로 합쳤습니다.
한국어 단어 검색
Postgres 내장 전문 검색은 형태소를 모릅니다. 한국어는 조사가 붙어 있어서 그대로 넣으면 어절 하나가 통째로 토큰이 되어 거의 맞지 않습니다. 그래서 글자를 두 개씩 자른 바이그램("소각결정" → 소각, 각결, 결정)으로 저장하고, 외부 확장 없이 내장 기능(tsvector + GIN 인덱스)만으로 검색했습니다.
RRF로 합치기
RRF는 점수 대신 순위만 봅니다. 각 경로에서 r위인 문서에 1/(60 + r)점을 주고 더합니다. 벡터 유사도와 단어 검색 점수는 단위가 달라서 그대로 더할 수 없는데, 순위만 쓰면 그 문제가 없습니다. 각 경로에서 후보를 60개씩 가져온 뒤 합칩니다.
단어 검색 상위 자리 보장
순수 RRF만 쓰니 제목이 정확히 맞는 문서가 묻혔습니다. 벡터 검색 상위 조각들이 단어도 조금씩 맞아서 점수를 더 받았기 때문입니다. 그래서 상위 5개 중 2개(top_k × 0.4)는 단어 검색 상위에 먼저 내주도록 했습니다.
이렇게 바꾼 뒤 0.375에서 0.667로 올랐습니다.
순위 점수가 전부 0이었던 버그
그런데 단어 검색 경로의 순위 점수(ts_rank_cd)가 전부 0이었습니다. 바이그램 문자열을 tsvector 형식으로 그대로 형변환해서 넣었더니 단어 위치 정보가 빠졌고, 위치를 보는 순위 함수가 모든 문서에 0을 돌려준 것입니다. to_tsvector('simple', …)로 넣도록 바꾸자 같은 평가셋에서 0.833이 됐습니다.
제목 가중치, 출처, 최신성
사흘 뒤 남은 실패를 정리했습니다. 공시는 제목에 유형이 그대로 적혀 있어서 제목이 맞는 것이 중요했습니다.
- 제목은 A, 본문은 D로 가중치를 다르게 두고, 제목만 보는 후보 경로를 하나 더 두었습니다. 질문 핵심어가 제목에 직접 들어간 문서는 한 자리를 보장합니다.
- 출처별 가중치를 곱합니다. 공시·통계(DART·ECOS·KRX) 1.15, 증권사 API(KIS) 1.10, 뉴스 1.00. 차이를 크게 두면 최신 뉴스가 오래된 공시에 늘 밀리기 때문에 15% 안에서만 조정했습니다.
- 최신성 점수를 곱합니다. 문서 종류마다 낡는 속도가 달라서 반감기를 뉴스 14일, 공시 90일, 재무 180일, 거시 지표 30일로 두었습니다.
return 0.5 + 0.5 * math.exp(-math.log(2) * age_days / half_life)이 단계에서 Recall@5는 1.000(7개 중 7개)이 됐습니다. 답이 없는 질문은 여전히 무언가를 돌려주고, 이건 관찰 항목으로 남겨 두었습니다.
0.375
벡터 검색만 (청크 10,195개)
0.667
+ 단어 검색, RRF
0.833
+ 위치 정보 버그 수정
1.000
+ 제목·출처·최신성
검색 앞에서 빠진 문서
운영 첫 배치에서는 검색이 아니라 수집에서 문제가 나왔습니다. 새로 추가한 7종목에 1년 치 공시를 채웠는데, 사업보고서가 한 건도 들어오지 않았습니다. 정기공시를 목록 맨 끝에 붙이고 있었는데, 호출하는 쪽이 앞에서부터 20건만 잘라 가져갔기 때문입니다. 정기공시를 목록 앞에 두도록 고쳤습니다. 없는 문서는 검색이 아무리 좋아도 찾을 수 없습니다.
정리
평가셋을 먼저 만든 덕분에 바꿀 때마다 좋아졌는지를 숫자로 볼 수 있었습니다. 효과가 없던 조각 수 상한은 되돌렸고, 문서가 늘었을 때 벡터 검색만으로는 부족하다는 것도 감이 아니라 0.375라는 숫자로 확인했습니다. 다만 평가셋이 7~8문항이라 작고, 문서를 다시 모으면 정답도 바뀌어서 평가셋을 같이 고쳐야 한다는 한계가 있습니다.