 엔지니어링
AI 에이전트 분업을 위한 MSA 서비스 경계 설계
· 알고수
- #ai-dev
- #architecture
- #msa
- #kubernetes
문제
혼자 만드는 서비스인데도, 모놀리스로는 에이전트 하나가 코드베이스 전체를 알아야 했고 맥락이 넓어질수록 정확도가 떨어졌다.
결정
데이터 소유권 기준으로 서비스를 나눠 에이전트의 책임 경계와 맞추고, 서비스 경계·통신·인증·배포는 사람이 결정하고 AI가 실행하게 나눴다.
결과
방향은 사람이, 세부 구현은 AI가 맡아 혼자서도 6개 서비스를 일관된 품질로 유지했다.
MSA를 고른 이유
MSA(마이크로서비스 아키텍처)는 하나의 큰 애플리케이션 대신 작은 서비스 여러 개로 나눠 만드는 방식입니다.
알고수를 설계할 때 가장 먼저 고민한 건 아키텍처 패턴이 아니었습니다. AI 에이전트에게 어떻게 일을 시킬 것인가였습니다.
모놀리스로 만들면 하나의 에이전트가 전체 코드베이스를 이해해야 합니다. 인증 로직을 고치려면 제출 로직도 알아야 하고, DB 스키마도 파악해야 합니다. 에이전트에게 주는 지시가 짧고 범위가 좁을수록 핵심 지시를 더 잘 따른다는 건 이미 겪어 본 일이었습니다.
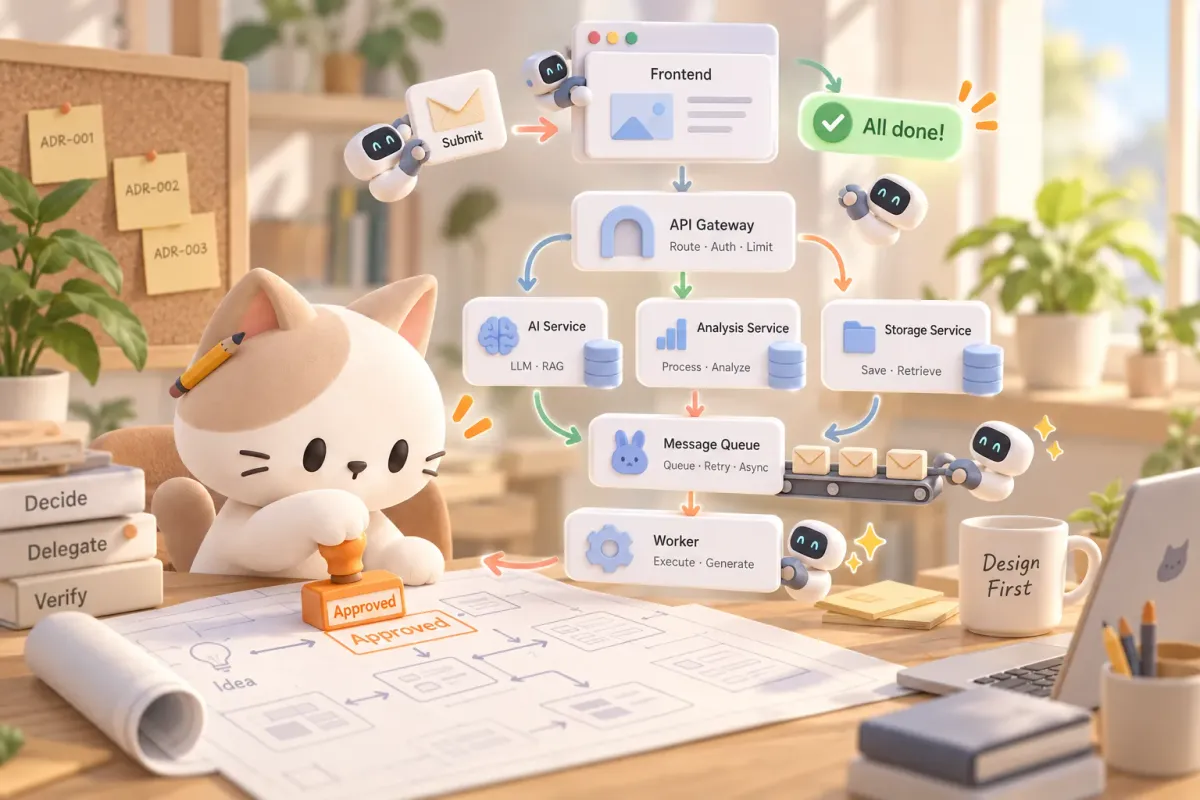
반대로 서비스를 작은 단위로 나누면 어떨까. AI가 관리하는 영역이 좁아질수록 역할이 분명해지고, 한 서비스 안에서의 판단이 더 정확해질 거라 생각했습니다. 인증·보안 담당 에이전트(Gatekeeper)는 Gateway만, DB 담당 에이전트(Librarian)는 DB 스키마만, 제출 흐름 담당 에이전트(Conductor)는 Submission만 맡깁니다. 에이전트의 책임 경계와 서비스의 경계를 일치시키는 것. 이게 MSA를 선택한 핵심 이유였습니다.
물론 MSA는 복잡합니다. 서비스 간 통신, 분산 트랜잭션, 배포 파이프라인처럼 모놀리스에서는 고민하지 않아도 될 문제들이 생깁니다. 하지만 그 복잡성을 AI 에이전트가 분담해줄 수 있다면, 트레이드오프가 성립한다고 판단했습니다.
서비스 분리 기준
서비스 분리 기준은 단순했습니다. 데이터의 소유권이 다르면 서비스를 나눕니다.
사용자 정보를 관리하는 Identity, 코드 제출을 관리하는 Submission, 문제를 관리하는 Problem은 각각 자기 데이터베이스를 갖습니다. 나중에 분리하면 마이그레이션 지옥이 된다는 걸 알고 있었기 때문에 DB는 초기에 서비스별로 나눴습니다. 다만 Gateway가 Identity의 DB에 직접 붙는 구조가 한동안 남아 있었고, Identity 서비스에 API를 만들어 그 연결을 끊은 뒤에야 다른 서비스의 DB에 직접 접근하지 않는다는 원칙(Database per Service)이 실제로 지켜졌습니다.
비동기 작업은 별도 워커로 뺐습니다. GitHub Push와 AI 분석은 시간이 오래 걸리는 작업이라, 사용자를 기다리게 할 수 없었습니다. GitHub Worker와 AI Analysis를 각각 독립 서비스로 만들고 RabbitMQ로 연결했습니다.
Gateway는 유일한 외부 진입점입니다. 인증, 라우팅, Rate Limit, SSE(서버가 브라우저로 실시간 알림을 보내는 방식) 스트리밍을 담당합니다. 나머지 서비스는 클러스터 내부에서만 통신합니다.
k3s on OCI ARM (24GB · 4 OCPU)
| 서비스 | 기술 | 포트 | 맡은 일 |
|---|---|---|---|
| Frontend | Next.js 15 · App Router | 3001 | Tailwind, shadcn/ui, SSE 구독 |
| Gateway | NestJS | 3000 | OAuth + JWT, X-Internal-Key 발급, Rate Limit, SSE |
| Identity | NestJS · identity_db | 3004 | 사용자/스터디/알림/공유 링크 |
| Submission | NestJS · submission_db | 3003 | Saga Orchestrator · 코드리뷰 |
| Problem | NestJS · problem_db | 3002 | 문제 CRUD · 마감 관리 |
| GitHub Worker | Node.js · prefetch=2 | 9100 | submission.github_push 큐 → GitHub Push |
| AI Analysis | FastAPI · Circuit Breaker | 8000 | submission.ai_analysis 큐 → Claude API |
| Claude API | claude-haiku-4-5-20251001 (서비스의 AI 코드 리뷰 기능이 호출하는 모델) | 없음 | MAX_TOKENS=8192, JSON 4-step fallback 파싱(응답 JSON 파싱이 실패하면 다음 방법으로 넘어가는 4단계 대비책) |
이 구조에서 AI 에이전트의 역할 분담이 자연스럽게 정해졌습니다. 대부분은 서비스 하나를 맡습니다. 보안 담당은 Gateway, 제출 흐름 담당은 Submission, 문제 담당은 Problem을 맡는 식입니다. DB와 인프라처럼 여러 서비스에 걸친 일은 따로 담당을 두었습니다. 서비스 경계가 대부분의 에이전트에게 책임 경계가 되니, "이건 누구 담당이지?"라는 혼란이 사라졌습니다.
통신 방식의 결정
서비스를 나누면 통신 방식을 정해야 합니다. 4가지 패턴을 용도에 따라 골라 썼습니다.
HTTP 동기
즉시 응답 (Gateway → 서비스)
RabbitMQ 비동기
장시간 작업 (GitHub Push, AI)
Redis Pub/Sub
실시간 이벤트 전파
SSE
브라우저 실시간 스트리밍
HTTP 동기 호출은 즉시 응답이 필요한 경우에 사용합니다. Gateway에서 Identity, Submission, Problem으로의 호출이 여기에 해당합니다. 내부 호출에는 X-Internal-Key 헤더를 붙여서 외부 접근을 차단합니다. 이 키 검증 로직은 보안 담당 에이전트가 설계했는데, crypto.timingSafeEqual을 써서 타이밍 어택을 방지하는 것까지 에이전트가 스스로 적용했습니다.
RabbitMQ 비동기 메시징은 시간이 오래 걸리는 작업에 사용합니다. 코드 제출 후 GitHub Push와 AI 분석을 동기로 처리하면 사용자가 30초 넘게 기다려야 합니다. MQ로 비동기 처리하면 제출 즉시 응답할 수 있습니다. GitHub Worker의 prefetch=2(한 번에 최대 2건만 가져와 처리)는 인프라 담당 에이전트(Architect)가 제안한 설정입니다. GitHub API Rate Limit과 OCI 무료 티어 리소스를 고려한 동시 처리량 제한이었습니다.
Redis Pub/Sub은 서비스 간 실시간 이벤트 전파에 사용합니다. 제출 상태가 바뀔 때마다 submission:status:{id} 채널로 메시지를 발행하고, Gateway에서 SSE 연결을 맡는 SSE Controller가 이를 구독합니다.
SSE는 브라우저까지 실시간 스트리밍하는 마지막 구간입니다. 최대 연결 시간 5분, 30초 heartbeat, 소유권 검증 같은 안전장치는 보안 담당과 제출 흐름 담당 에이전트가 함께 만들었습니다. 특히 SSE 연결마다 Redis subscriber를 만들면 커넥션 풀이 바닥나는 문제가 있었습니다. 이를 subscriber 하나를 함께 쓰는 공유 subscriber 패턴으로 해결한 건 제출 흐름 담당의 판단이었습니다.
각 통신 패턴의 선택 자체는 사람이 결정했습니다. "제출 후 GitHub Push는 비동기여야 한다"는 건 아키텍처 판단입니다. 하지만 그 결정을 실행하는 과정에서의 세부 설계는 AI 에이전트가 채워넣었습니다.
제출 한 건의 여정
이 아키텍처가 실제로 어떻게 동작하는지, 코드 제출 한 건의 여정을 따라가 보겠습니다.
사용자가 "제출" 버튼을 누르면 Gateway가 JWT를 검증하고, Submission Service의 Saga Orchestrator가 전체 흐름을 관장합니다. Saga 패턴은 여러 서비스에 걸친 작업을 단계별로 진행하고, 실패하면 정해진 방식으로 되돌리거나 건너뛰는 방식입니다.
Saga 상태 전이
이 Saga 설계에서 사람이 결정한 것과 AI가 실행한 것이 명확히 나뉩니다.
사람이 결정한 것
DB에 먼저 저장하고 MQ에는 나중에 발행하는 순서. 서비스가 재시작되면 DB에는 기록이 남지만 MQ 메시지는 사라지기 때문입니다. 메시지를 먼저 보내고 저장하기 전에 서비스가 죽으면 기록 없는 작업이 생기므로, 항상 DB에 먼저 남깁니다. 작업을 잃지 않기 위한 이 순서는 아키텍처 원칙이지, AI가 스스로 판단할 영역은 아닙니다.
AI(제출 흐름 담당)가 실행한 것
낙관적 락으로 역진행을 방지하는 구현. 모든 상태 전이에서 WHERE sagaStep = 현재단계 조건을 걸어 중복 처리를 막았습니다. 단계별 타임아웃과 재시도 로직(DB_SAVED 5분, GITHUB_QUEUED 15분, AI_QUEUED 30분)도 이 에이전트가 설계했습니다. 서비스가 재시작되면 1시간 이내의 미완료 Saga를 자동으로 재개하는 복구 로직까지 만들었습니다.
사람은 "실패해도 데이터를 잃으면 안 된다"는 원칙을 세웠고, AI는 그 원칙을 지키는 구체적 메커니즘을 만들었습니다.
인증·보안·배포의 결정 주체
아키텍처의 나머지 결정들도 같은 패턴을 따릅니다. 방향은 사람이, 실행은 AI가.
인증: httpOnly Cookie를 쓸 것인지 localStorage를 쓸 것인지는 사람이 결정했습니다. XSS 공격에 대한 방어가 이유였습니다. 하지만 OAuth 플로우의 구현, JWT 자동 갱신 로직(만료 5분 전 TokenRefreshInterceptor), 알고리즘을 HS256으로 고정하는 것과 같은 세부 사항은 보안 담당 에이전트가 보안 원칙에 따라 실행했습니다.
보안: "모든 컨테이너는 non-root로 실행하고, 권한 상승을 차단한다"는 원칙은 사람이 세웠습니다. 인프라 담당 에이전트가 이 원칙을 모든 k8s(쿠버네티스) 매니페스트에 일관되게 적용했습니다. 파일 시스템은 읽기 전용(readOnlyRootFilesystem), 리눅스 권한은 전부 제거(capabilities.drop: ALL), 쓰기가 꼭 필요한 경로에만 임시 쓰기 공간(emptyDir)을 붙였습니다. 6개 서비스에 동일한 보안 설정을 빠짐없이 적용하는 건 사람 혼자 하면 하나쯤 빼먹기 쉽습니다. NetworkPolicy로 default-deny 후 필요한 통신만 허용하는 것도 같은 맥락입니다.
배포: GitOps를 택한 건 사람의 결정입니다. GitOps는 "클러스터에 무엇을 띄울지"를 Git 저장소에 적어 두고, 도구가 그 내용대로 클러스터를 맞추는 배포 방식입니다. main 브랜치에 push하면 GitHub Actions가 ARM64 이미지를 빌드해 GitHub의 컨테이너 이미지 저장소(GHCR)에 main-{git-sha} 태그로 올리고, Git의 설정을 클러스터에 자동 반영하는 도구 ArgoCD가 k3s 클러스터에 배포합니다. latest 태그를 절대 쓰지 않는 것, RollingUpdate에서 maxUnavailable: 0으로 무중단 배포를 보장하는 것, initContainer로 DB 마이그레이션을 앱 시작 전에 실행하는 것과 같은 결정은 인프라 담당 에이전트가 인프라 원칙에 따라 설계했습니다.
OCI ARM 무료 티어의 리소스 배분도 마찬가지입니다. 24GB RAM, 4 OCPU라는 제약 안에서 각 서비스의 request/limit(보장받는 자원과 최대 자원)을 어떻게 나눌지는 인프라 담당이 판단했습니다. AI Analysis가 유일하게 2Gi 메모리 제한을 갖는 건, Claude API 응답 파싱에 메모리가 많이 필요하다는 실측 데이터에 기반한 결정이었습니다.
설계의 경계
MSA를 AI와 함께 설계하면서 발견한 가장 중요한 것은 경계입니다.
AI에게 맡길 수 있는 설계가 있고, 사람이 해야 하는 설계가 있습니다. "DB를 서비스별로 분리한다", "외부 API 호출은 비동기로 처리한다", "인증은 httpOnly Cookie를 쓴다" 같은 아키텍처 방향은 비즈니스 맥락과 트레이드오프에 대한 이해가 필요합니다. AI가 스스로 판단하기엔 아직 넓은 영역입니다.
반면 그 방향이 정해진 뒤의 실행(낙관적 락 구현, 보안 설정 일관 적용, 타임아웃 수치 설정, 통신 패턴의 세부 설계)은 AI가 사람보다 잘합니다. 빠뜨리지 않고, 일관되게, 6개 서비스에 동일한 원칙을 적용합니다.
그렇다면 MSA 선택은 맞았을까. AI 에이전트의 역할을 분명하게 만들기 위해 서비스를 나눴고, 실제로 에이전트별 책임 경계가 서비스 경계와 일치하면서 관리가 수월해졌습니다. 물론 MSA의 복잡성은 그대로 존재합니다. 하지만 그 복잡성을 AI가 분담해주니, 혼자서도 6개 서비스를 일관된 품질로 유지할 수 있었습니다.
아키텍처는 정답이 없습니다. 다만 "AI와 함께 개발한다"는 전제가 생기면, 그 전제에 맞는 아키텍처가 달라진다는 건 확실합니다.