 AI 에이전트
슬라이딩 윈도우 기반 AI 에이전트 컨텍스트 관리
· 알고수
- #agent
- #documentation
- #sliding-window
- #context-optimization
- #claude-code
152번째 스프린트의 기록
알고수는 스프린트(짧은 작업 주기)를 150번 넘게 돌렸고, 이 글을 쓴 건 152번째 스프린트 때입니다. 처음부터 스프린트마다 결정 기록(ADR: 무엇을 왜 그렇게 정했는지 남기는 문서)을 쓴 건 아니었어요. 62번째 스프린트 무렵부터 매 스프린트의 결정과 회고를 한 파일로 묶기 시작했습니다. 그 뒤로 docs/adr/sprints/ 폴더에 sprint-62.md부터 sprint-151.md까지, 지금은 90개 가까이 쌓였어요.
에이전트가 읽는 문서는 이것만이 아닙니다.
CLAUDE.md: 에이전트가 매 세션 자동으로 읽는 프로젝트 규칙 파일.claude/commands/agents/: 에이전트 12개 각각의 역할과 금지사항을 적은 파일(페르소나)들MEMORY.md: 스프린트마다 갱신하는, 지난 작업의 요약 메모
기록이 남아 있다는 건 좋은 일이에요. 그런데 동시에 위험한 일이기도 합니다.
이 모든 문서를 매 세션 에이전트에게 들이밀 수는 없거든요.
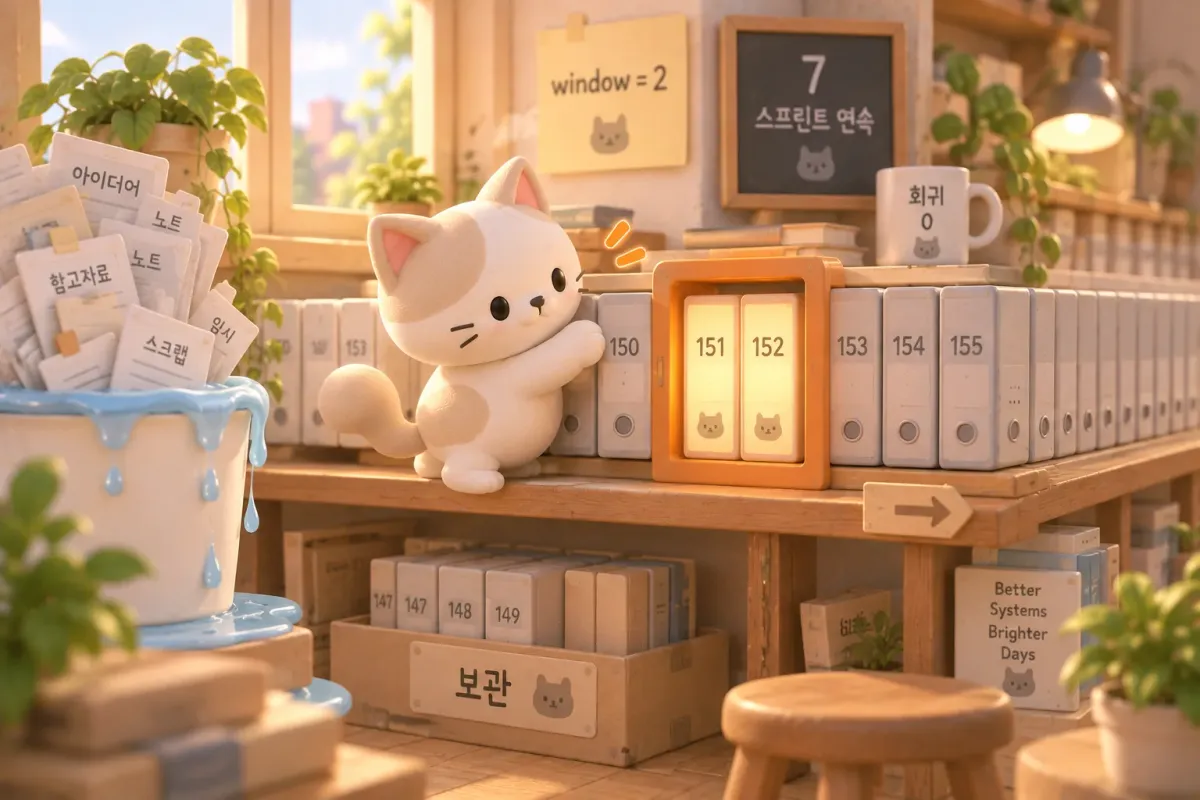
이 글은 그 단순한 사실을 인정하기까지의 기록입니다. 그리고 그 위에 슬라이딩 윈도우 알고리즘을 얹어 컨텍스트를 줄인 방법, 최근 7 스프린트 연속으로 회귀 0건을 만든 작은 규칙들에 대한 이야기예요.
사람도 에이전트도 잊는 기억
먼저 인정해야 할 게 있어요. 기억은 휘발됩니다.
사람이 그래요. 6개월 전에 왜 이 enum을 추가했는지, 왜 이 마이그레이션을 따로 배포했는지, 왜 이 함수 이름이 이렇게 어색한지, 시간이 지나면 잊습니다. 코드를 다시 읽어도 "왜"는 나오지 않아요. 코드는 "무엇을"만 보여주거든요.
에이전트는 더 심합니다.
에이전트는 매 세션 빈 컨텍스트로 시작해요. 이전 대화에서 합의한 것, 어제 고친 회귀 패턴, 지난주에 정한 기준값의 위치를 다음 세션의 에이전트는 모릅니다. 새로 온 사람과 같은 상태예요. 사람은 며칠 쉬어도 어렴풋이 기억하지만, 에이전트는 정확히 0입니다.
그래서 알고수에서는 일찍부터 문서화에 공을 들였어요. 잊혀선 안 될 것들을 한곳에 모으기 시작했습니다.
- 결정과 그 배경은 스프린트별 결정 기록으로
- 변하지 않는 규약은
CLAUDE.md로 - 각 에이전트의 역할은
.claude/commands/agents/의 페르소나 파일로
효과가 있었던 문서화
작은 사례 하나만 볼게요.
145번째부터 151번째까지 7번의 스프린트 동안, 모니터링 설정에서 같은 종류의 실수가 다시 나지 않도록 막는 검사 항목이 하나씩 늘어 8가지가 됐습니다. 한 번 잡힌 회귀는 다음 스프린트가 같은 자리에서 다시 다치지 않도록 결정 기록에 규칙으로 남겼어요.
그 8가지는 이렇습니다. 지표(metric) 이름, 라벨, 대시보드 패널 제목, 대시보드 변수, 알림 규칙의 라벨, 대시보드 구조, 정규식이 예외 입력에도 버티는지, 그리고 백엔드와 프론트엔드의 enum 값이 서로 맞는지. 한 번 막은 항목은 다음 스프린트에서 다시 뚫리지 않았습니다.
sprint-145.md부터 sprint-151.md까지 차례로 열어 보면, 각 스프린트의 "교훈" 섹션이 다음 스프린트의 "신규 패턴" 섹션으로 이어집니다. 문서가 단단한 리듬을 만들어냈어요.
7스프린트
연속 회귀 0건
145~151번째 스프린트
8
쌓인 검사 항목
지표 이름 → enum 동기화
17스프린트
브랜치 규칙 준수
main 브랜치에 직접 커밋하지 않기
한 번 얻은 교훈을 다시 얻으려고 대가를 치르지 않아도 되는 것. 유지보수에서 아끼는 진짜 비용은 그거예요.
문제
쌓이는 문서가 매 세션 에이전트의 컨텍스트를 잠식하기 시작했다. 꽉 찬 물통에 물을 더 붓는 일이었다.
결정
슬라이딩 윈도우 알고리즘에서 빌려 온 단순한 규칙으로 컨텍스트를 줄이기로 했다.
결과
4계층 저장 구조로 7 스프린트 연속 회귀 0건을 달성했다.
적이 되기 시작한 문서
여기까지는 행복한 이야기예요. 문제는 그다음이었습니다.
기록을 시작하고 40 스프린트쯤 지나 100번째 스프린트를 넘기자, 스프린트별 결정 기록이 40개 가까이 쌓였습니다. 그 무렵부터 이상한 일이 생기기 시작했어요. 에이전트가 세션을 시작할 때 컨텍스트로 읽어 들이는 문서의 양이 너무 커진 겁니다.
처음엔 자랑스러웠어요. "우리 프로젝트는 결정이 다 기록돼 있어." 그런데 어느 순간부터 에이전트가 핵심을 놓쳤습니다. 결정 기록에 분명히 적힌 규칙을 어기고, CLAUDE.md에 강조해 둔 금지사항을 또 어겼어요.
문서는 그대로인데, 시간이 갈수록 효과가 떨어졌습니다.
원인은 단순했어요.
꽉 찬 물통에 물을 계속 붓고 있었던 거예요.
꽉 찬 물통: 컨텍스트의 한계
LLM의 컨텍스트 윈도우는 토큰 한도가 전부가 아닙니다. 한도 안이더라도 정보가 너무 많으면 모델의 주의(attention)가 흩어져요. lost-in-the-middle이라고 불리는 현상입니다. 긴 입력의 가운데에 끼인 규칙일수록 덜 보이고, 정작 봐야 할 한 줄이 잡음에 묻혀 버려요.
문서가 늘수록 이런 일이 잦아졌습니다. 매 세션 시작할 때 들어가던 문서를 늘어놓으면 이렇습니다.
[CLAUDE.md 200줄]
[MEMORY.md 200줄]
[ADR sprint-062 ~ sprint-152, 각 ~10KB]
[.claude/commands/agents/ 12개 페르소나]
[docs/runbook/*.md 다수]
[기타 도메인 문서들]
─────────────────────────
총량: 컨텍스트 한도의 절반이 시작부터 채워짐
실제 작업할 코드 + 대화 공간: 절반
attention의 무게중심: 어디에도 못 모임토큰이 남아 있어도 모델의 "주의력"에는 한계가 있어요. 강조된 규칙 100개는 강조된 규칙 1개보다 약합니다. 모두 중요하다고 표시하면, 결국 어느 것도 중요하지 않은 거예요.
그렇다고 그냥 "줄이자"고 하기엔 무서웠습니다. 어느 결정 기록 하나가 다음 스프린트의 회귀를 막을 결정적인 한 줄을 갖고 있을 수 있거든요. 뒷부분을 기계적으로 잘라내면 무엇을 잃을지 통제할 수 없습니다.
슬라이딩 윈도우 알고리즘
실마리는 알고리즘 책에서 왔습니다. 정확히는 알고리즘 스터디 플랫폼을 만들면서 매주 보던 그 패턴이요.
슬라이딩 윈도우(sliding window) 알고리즘은 배열이나 스트림을 처리할 때 모든 원소를 한꺼번에 들고 있지 않습니다. 일정한 크기의 "윈도우"만 유지하고, 새 원소가 들어오면 가장 오래된 원소를 밖으로 밀어내요. 부분합, 최대 부분 수열, 네트워크 패킷 흐름 제어에 두루 쓰이는, 한정된 공간에서 끝없는 스트림을 다루는 표준 기법입니다.
[1, 2, 3, 4, 5, 6, 7, 8, ...]   ← 입력 스트림 (무한)
   ┌───────┐
   │ 1 2 3 │                      ← 윈도우 크기 3
   └───────┘
      ┌───────┐
      │ 2 3 4 │                   ← 1이 빠지고 4가 들어옴
      └───────┘
         ┌───────┐
         │ 3 4 5 │                ← 2가 빠지고 5가 들어옴
└───────┘스프린트도 같았어요. 152번을 지났고 앞으로도 계속 늘어납니다. 끝없는 스트림이고, 컨텍스트 한도라는 유한한 공간에 다 담을 수 없어요. 그렇다면 윈도우만큼만 들고, 나머지는 영구 저장소에서 필요할 때 꺼내자.
이게 시작이었습니다.
sprint-window.md
핵심은 memory/sprint-window.md라는 파일입니다. 에이전트가 매 세션 가장 먼저 읽는 "지금 하고 있는 일" 메모예요. 팀이 함께 보는 저장소 파일이 아니라 에이전트를 돌리는 Claude Code가 세션마다 자동으로 읽어 들이는, 제 컴퓨터의 메모리 폴더에 있는 파일이에요.
윈도우 크기는 2입니다. 파일은 이렇게 생겼어요.
---
name: 스프린트 윈도우
description: 최근 2 스프린트만 유지하는 슬라이딩 윈도우
status: active
---

## [1] 완료 — Sprint 151: 프로그래머스 SQL 자동 언어 선택
- 기간, end_commit, 머지된 PR, 작업 요약, Critic 호출 결과,
  검증, 회귀 차단 레이어, 신규 패턴, 교훈, 다음 스프린트 이월

## [2] 진행 — Sprint 152: 슬라이딩 윈도우 블로그 글 작성
- start_commit, 목표, 계획 작업, 담당 에이전트[1]은 직전에 끝난 스프린트, [2]는 지금 진행 중인 스프린트. 그게 다입니다. 그 이전은 윈도우 밖이에요.
처음에는 크기 3, 4도 시도해 봤습니다. 많이 기억할수록 좋지 않을까 싶어서요. 결과는 반대였어요. 윈도우가 커질수록 [2]의 진행 중인 작업이 흐려졌습니다. 너무 오래된 결정에 발이 묶이거나, 직전 결정과 충돌하는 옛 패턴이 끌려 나왔어요.
크기 2가 적당했습니다. 직전 스프린트의 교훈은 진하게 남기고, 그 이전은 필요할 때만 결정 기록을 직접 열어 보는 구조예요.
상태 하나로 슬라이드를 자동화 (status: idle | active)
윈도우는 어떻게 밀릴까요? 자동입니다.
파일 머리(frontmatter)의 status 값이 상태 기계 역할을 해요. 제가 스프린트를 시작할 때 실행하는 /start와 끝낼 때 실행하는 /stop이 이 값을 바꾸면서 윈도우를 밉니다.
sprint-window.md가 밀리는 방식
/start를 실행하면 [2]에 새 스프린트 정보가 채워지고 status: active가 됩니다. /stop에서는 더 많은 일이 일어나요.
- [2]의 작업 결과(머지된 PR, 검증, 교훈)가 [1]로 옮겨지고, 옛 [1]은 밀려납니다
- 밀려난 옛 [1]은
docs/adr/sprints/sprint-{N}.md에 영구 저장됩니다 - [2]는 다음 스프린트를 위한 빈칸이 됩니다
status: idle로 바뀝니다
에이전트는 윈도우 안에서만 일하고, 윈도우 밖은 영구 저장소가 맡습니다. 결정 기록으로 넘어간 결정은 사라지지 않아요. 매 세션 자동으로 읽히는 목록에서 빠질 뿐, 필요한 순간 정확한 경로로 꺼낼 수 있습니다.
4계층 저장 구조
슬라이딩 윈도우 하나로는 부족했어요. 윈도우는 "지금 무엇을 들고 있을까"를 정하지만, 윈도우 밖의 것들도 어딘가에 살아 있어야 했거든요. 그래서 저장 구조를 계층으로 나눴습니다.
4계층 저장 구조
계층은 넷입니다. 지금 하는 일(윈도우), 목차(인덱스), 변하지 않는 규칙, 영구 저장소. 아래 표에서 규약(CLAUDE.md)과 페르소나 두 줄이 함께 "변하지 않는 규칙" 계층이에요.
| 계층 | 파일 | 바뀌는 주기 | 자동 로딩? | 무엇을 보존하나 |
|---|---|---|---|---|
| 윈도우 | sprint-window.md | 매 스프린트 | ✅ | 직전 완료 + 진행 중 (크기 2) |
| 인덱스 | MEMORY.md | 매 스프린트 | ✅ | 스프린트별 1줄 요약 + 영구 저장소 링크 |
| 변하지 않는 규칙: 규약 | CLAUDE.md | 거의 안 바뀜 | ✅ | 코딩 규칙, 금지사항, 보안 규칙 |
| 변하지 않는 규칙: 페르소나 | .claude/commands/agents/ | 거의 안 바뀜 | ✅ | 에이전트 12개의 역할·금지사항 |
| 영구 저장소 | docs/adr/sprints/ | 추가만 됨 | ❌ | 모든 스프린트의 결정·교훈 |
핵심은 "잊는 곳"과 "기억하는 곳"을 나누는 것이에요.
에이전트의 컨텍스트는 "잊는 곳"입니다. 윈도우가 밀리면서 옛것은 자연스럽게 빠져요. 그래야 매 세션 새 작업에 주의가 모입니다. 영구 저장소는 "기억하는 곳"이에요. 한 번 들어간 결정은 사라지지 않습니다. 자동으로 끌려오지 않을 뿐, 경로를 알면 언제든 꺼낼 수 있어요.
MEMORY.md: 본문이 아니라 인덱스
MEMORY.md는 200줄 이내로 유지합니다. 본문이 아니라 인덱스(목차)예요.
- Sprint 151 — 프로그래머스 SQL 자동 언어 선택 (2026-05-13):
  Backend Problem entity ProblemCategory enum 추가 + ... (1줄 요약)
  ADR: [sprint-151.md](../../../../Desktop/leo.kim/AlgoSu/docs/adr/sprints/sprint-151.md)
- Sprint 150 — 이월 시드 정리 (2026-05-13):
  Sprint 149 자동화 후보 3건 단일 일자 3 PR 묶음 처리 ...
ADR: [sprint-150.md](...)각 줄은 "이런 스프린트가 있었다"는 표시일 뿐이고, 본문은 결정 기록에 있어요. 에이전트가 어떤 결정을 정확히 다시 보고 싶으면 인덱스의 경로를 따라 영구 저장소로 들어갑니다.
이렇게 하면 매 세션 컨텍스트에 들어가는 양은 스프린트당 1줄입니다. 스프린트당 ~10KB짜리 본문이 아니라요. 차이가 큽니다.
CLAUDE.md와 페르소나: 변하지 않는 기준
이 두 곳은 거의 바뀌지 않아요. 코딩 규칙, 금지사항, 보안 규칙, 에이전트 역할은 스프린트마다 흔들리면 안 되거든요.
대신 바뀌지 않는 내용은 늘 컨텍스트에 있어도 부담이 작습니다. 모델이 매번 새로 이해해야 할 변화가 없으니까요. 변하지 않는 강한 규칙이 자주 바뀌는 약한 규칙보다 낫습니다. 무엇을 강하게 박아 둘지 고르는 게 중요했어요.
특히 .claude/commands/agents/ 폴더는 150번째 스프린트에서 git으로 관리하도록 바꿨어요. 그 전까지는 git에서 제외된 로컬 전용 폴더였습니다. 여러 컴퓨터 사이에 내용이 어긋나는 문제가 쌓였고, 결국 저장소에 올려 에이전트 12개의 정의가 한곳에만 있도록 했어요(단일 원천, SSoT).
7 스프린트 연속 회귀 0건
문서와 슬라이딩 윈도우를 함께 운영한 145~151번째 스프린트에서 숫자로 가장 뚜렷했던 변화는 회귀 빈도였어요.
8가지
회귀를 막는 검사 항목
145~151번째 스프린트 동안 쌓임
7스프린트
연속 회귀 0건
문서가 작동한 증거
0건
브랜치 규칙 위반
134번째 스프린트 이후 17 스프린트 (main 직접 커밋 금지)
물론 이게 다 슬라이딩 윈도우 덕분은 아닙니다. 아래에서 설명할 두 가지 리뷰와 에이전트 12개의 역할 분담이 함께 작용했어요.
다만 슬라이딩 윈도우가 있었기에 이 장치들이 "일관되게" 작동할 수 있었습니다. 직전 스프린트의 교훈은 흐려지지 않고, 그 이전의 옛 결정에는 발이 묶이지 않는 균형. 그게 회귀를 막는 토대였어요.
자동 리뷰도 슬라이딩 윈도우와 한 세트
이 글에는 리뷰가 두 가지 나옵니다. 커밋마다 도는 자동 리뷰(Auto-Critic)와 머지 직전 최종 리뷰(Critic)예요. 검토를 하는 건 둘 다 리뷰 에이전트 Critic입니다. 에이전트들은 Anthropic의 Claude 모델로 돌지만, Critic의 검토에는 다른 회사의 코딩 모델(OpenAI Codex, gpt-5)을 써서 교차로 확인합니다.
자동 리뷰는 117번째 스프린트에 들어왔습니다. 코드를 바꾸는 커밋이 생길 때마다 Critic의 검토를 자동으로 예약해요. 머지 직전 최종 리뷰는 PR이 머지되기 전에 1차, 2차, 필요하면 3차까지 검토합니다.
Critic은 찾은 문제를 치명적 결함(P0), 심각한 결함(P1), 개선 권고(P2)로 나눠 알려 줍니다. 수정은 그 분야를 맡은 에이전트에게 다시 넘어가요.
중요한 건 이 교차 검토가 본 세션의 컨텍스트에 부담을 주지 않는다는 점이에요. Codex는 별도 프로세스로 돌고, 결과는 요약본만 들어옵니다. 본 세션의 컨텍스트 윈도우는 그대로예요.
슬라이딩 윈도우와 같은 철학입니다. "필요할 때만, 필요한 만큼만, 본 컨텍스트는 가볍게."
151번째 스프린트 한 번에 자동 리뷰가 4번 돌았지만 본 컨텍스트는 평소와 같았어요. 4번 모두 P0·P1은 0건, P2 1건만 나왔고, 2차 리뷰에서 해소돼 모두 문제없이 끝났습니다. (sprint-151.md에 전 과정이 기록돼 있습니다.)
잊는 법이 곧 기억하는 법
처음엔 "다 기억하면 좋겠다"고 생각했어요. 결정 기록도, 메모도, 모든 결정과 교훈을 매 세션 들이밀면 에이전트가 더 똑똑하게 일할 거라고요.
정반대였습니다. 많이 들이밀수록 에이전트는 흐려졌어요. 모든 게 중요하면 어느 것도 중요하지 않으니까요. 꽉 찬 물통에 더 부어도 넘칠 뿐이듯, 가득 찬 컨텍스트에 더 얹어도 주의만 옅어졌습니다.
슬라이딩 윈도우가 가르쳐준 건 "무엇을 기억할까"보다 "무엇을 잊을까"가 먼저라는 점이었어요. 잊을 곳을 정해 두면 기억할 곳이 또렷해집니다. 윈도우 밖은 잊어요. 다만 영구 저장소에 정확한 경로로 남아 있어서, 필요한 순간 다시 꺼낼 수 있죠.
문서는 끝없이 쌓일 수 있습니다. 스프린트별 결정 기록은 90개에서 100개, 200개로 늘어날 거예요. 하지만 윈도우는 그대로 2입니다. 에이전트가 매 세션 들고 가는 무게는 늘지 않아요. 늘어나는 건 영구 저장소의 깊이와 인덱스의 선명함뿐입니다.
기억은 휘발됩니다. 그래서 문서가 필요해요. 그런데 문서도 너무 많으면 다시 휘발됩니다. 그래서 슬라이딩 윈도우가 필요했어요. 잊는 법을 배우는 것이, 결국 기억하는 법이었습니다.
다음 스프린트에도, 그다음에도 윈도우는 같은 크기로 굴러갈 거예요. 안에 든 내용은 매번 바뀌겠지만요. 그게 유지보수의 호흡법이라고 생각합니다. 들이쉰 만큼 내쉬어야 다음 숨이 들어오는 것처럼요.