 회고
AI와 함께한 67번의 스프린트 회고
· 알고수
- #retrospective
- #solo-dev
- #growth
67번째 스프린트 회고
출발점은 멀티에이전트 시스템에 대한 호기심이었습니다. "AI 에이전트 여러 명이 협업하면 혼자서도 서비스를 만들 수 있지 않을까?" 그 궁금증 하나로 시작한 프로젝트가 67번의 스프린트(짧은 작업 주기)를 지나며 하나의 플랫폼이 됐습니다.
- 67개 스프린트
- 전체 테스트 2,432개, 그중 사용자·인증 서비스의 분기(branch) 커버리지 99.51%
- 6개 마이크로서비스 + 1개 프론트엔드
- 사용자·인증 서비스(Identity)의 API 엔드포인트 34개
- 12개 AI 에이전트
숫자만 보면 깔끔합니다. 하지만 그 뒤에는 결정하고, 실수하고, 고치는 일이 반복됐습니다.
해보니까 보이는 것들
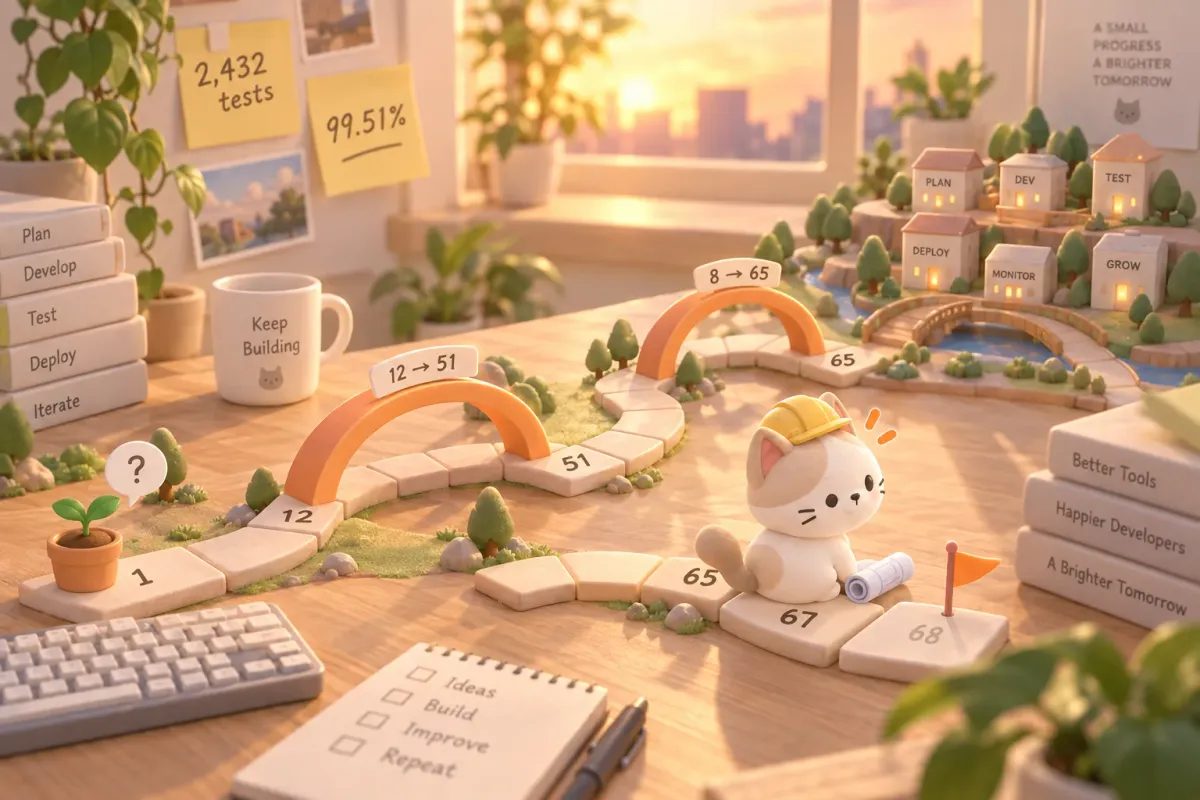
67 스프린트의 주요 지점
일찍 한 결정들
DB 분리: Sprint 12에서 결정, Sprint 51에서 빛남. 서비스가 3개뿐이던 때, 데이터베이스를 서비스별로 3개(identity_db, problem_db, submission_db)로 나눴습니다. 솔직히 과하다 싶었습니다.
DB는 나눴지만, 모든 요청을 받는 관문 서비스(Gateway)가 사용자 DB에 바로 붙는 지름길은 남아 있었습니다. Sprint 51에 그 직접 접근을 완전히 끊어내는 큰 리팩토링이 왔습니다. DB가 이미 나뉘어 있었기 때문에 마이그레이션이 훨씬 수월했습니다. 40스프린트 전의 "과한 설계"가 미래의 저를 구해줬습니다.
Sprint 12
DB 3개 분리 결정
Sprint 51
Gateway의 DB 직접 접근 제거
40 스프린트 뒤, 과한 설계가 미래를 구했다
httpOnly 쿠키: Sprint 8에서 결정, Sprint 65에서 빛남. 소셜 로그인(OAuth)을 붙이면서, 로그인 토큰(JWT)을 브라우저 저장소(localStorage) 대신 httpOnly 쿠키에 두기로 했습니다. httpOnly 쿠키는 페이지의 스크립트가 읽을 수 없어서, 악성 스크립트 삽입(XSS)으로 토큰을 빼앗길 위험이 줄어듭니다.
쿠키로 일찍 옮겨 둔 덕분에, 남아 있던 localStorage 토큰 함수 11개는 이미 실제 코드에서 쓰이지 않는 상태였습니다. Sprint 65에 이를 걷어낼 때(+42줄 / −440줄) 다른 코드를 고칠 필요 없이 지우기만 하면 됐습니다.
Sprint 8
httpOnly 쿠키 도입
Sprint 65
localStorage 함수 11개 제거
57 스프린트 뒤, 지우기만 하면 됐다
테스트 집착: 전체 테스트 2,432개, 사용자·인증 서비스 분기 커버리지 99.51%. 앞의 Sprint 51 작업에서는 API 34개를 새로 만들고 파일 19개를 통째로 바꿨습니다. 이게 가능했던 건 테스트가 안전망이 되어 줬기 때문입니다. "이거 고치면 저쪽이 깨지지 않을까?" 하는 불안 없이 과감하게 고칠 수 있었습니다.
미룬 결정들
타입 동기화를 자동화하지 않은 것. 서비스가 여러 개로 나뉜 구조(MSA)에서는 enum 값 하나를 추가해도 손으로 고칠 파일이 최소 5개였습니다. 사용자 서비스의 엔티티 → Gateway의 타입 → 프론트엔드의 api.ts → 화면 컴포넌트 순서로요.
한번은 FEEDBACK_RESOLVED라는 enum 값을 사용자 서비스에만 넣고 나머지에 전파하지 않았습니다. 이 누락은 두 스프린트 뒤에야 정리됐습니다. 코드 생성기나 공유 패키지를 일찍 들였다면 겪지 않았을 일입니다.
모니터링 알림을 늦게 연결한 것. 지표 수집(Prometheus)과 알림 발송(Alertmanager)은 진작 설정해 놓았습니다. 그런데 실제로 사람에게 알림이 가는 Discord 채널은 Sprint 63에야 연결했습니다. 도구가 있다는 것과 도구가 동작한다는 것은 다른 문제였습니다.
디테일에서 배운 것들
당연한 버그를 못 본 이유. 관리자 페이지의 피드백 필터가 브라우저(클라이언트)에서 동작하고 있었습니다. 목록은 서버가 한 페이지에 20건씩 나눠 보내고요. 그러면 어떻게 될까요? 지금 보이는 20건 안에서만 걸러지고, 다른 페이지의 데이터는 보이지 않습니다.
당연한 버그인데, 만들 때는 몰랐습니다. 필터를 서버로 옮기고, 전체 건수를 응답에 함께 담아야 했습니다. 커밋 8개, 파일 17개가 바뀌었습니다.
Discord 알림의 함정. 코드도 완성했고, 비밀값(Secret)도 만들었고, 소스 저장소의 배포 매니페스트도 썼습니다. 그런데 알림이 오지 않았습니다.
원인은 배포 설정만 따로 모아 둔 저장소(aether-gitops)였습니다. 실제 서버에 설정을 반영하는 도구(ArgoCD)는 이 배포 설정 저장소를 보고 동기화합니다. 저는 소스 저장소만 고치고 배포 설정 저장소의 환경변수(env)를 빠뜨렸던 겁니다.
알림 문제와 앞의 enum 전파 누락은 서로 다른 문제였지만, 이걸 고치는 시기에 함께 겹쳤습니다. 결국 사용자 서비스 → Gateway → 프론트엔드 세 층을 Sprint 66에서 통째로 다시 맞춰야 했습니다.
두 에피소드는 같은 이야기입니다. 부분만 보면 맞는데, 전체를 보면 빠진 게 있었습니다.
숫자로 보는 알고수
67개
총 스프린트
2,432건
총 테스트
사용자·인증 서비스 분기 커버리지 99.51%
15개
CI Jobs
푸시·PR마다 도는 자동 검사 15종
6개
마이크로서비스
Gateway · Identity · Submission · Problem · GitHub-Worker · AI-Analysis
12개
AI 에이전트
총괄 에이전트 Oracle + 11
34개
사용자·인증 API
Sprint 51에서 0 → 34
코더에서 빌더로
돌아보면 매 스프린트가 새로운 기술과의 첫 만남이었습니다. 여러 서비스에 걸친 작업을 단계별로 진행하고 실패하면 되돌리는 Saga 패턴을 처음 접했을 때의 막막함. 메시지 큐(RabbitMQ)의 메시지가 소비되지 않아 새벽까지 로그를 뒤졌던 밤. ArgoCD 동기화가 처음 성공했을 때의 안도감. 이런 순간이 67번 반복되면서 저도 모르게 변해 있었습니다.
처음에는 "이 기능을 어떻게 구현하지?"가 전부였습니다. 코드를 짜는 사람, 코더였죠. 스프린트가 쌓이면서 질문이 달라졌습니다. "이 결정이 20스프린트 뒤에도 괜찮을까?", "이 구조에서 장애가 나면 어디서 잡지?", "이 자동화가 정말 동작하는지 어떻게 증명하지?" 코드가 아니라 시스템을 만드는 사람, 빌더가 되어가고 있었습니다.
토큰과 시간을 갈아넣으며 생긴 것들이 있습니다.
Sprint 68은 아직 비어 있습니다. 하지만 스프린트는 계속될 겁니다. 호기심으로 시작한 프로젝트가 플랫폼이 됐고, 코더가 빌더가 됐으니까요. 다음 스프린트에서도 새로운 기술 앞에서 막막하겠지만, 67번의 경험이 말해줍니다. 해보면 됩니다.